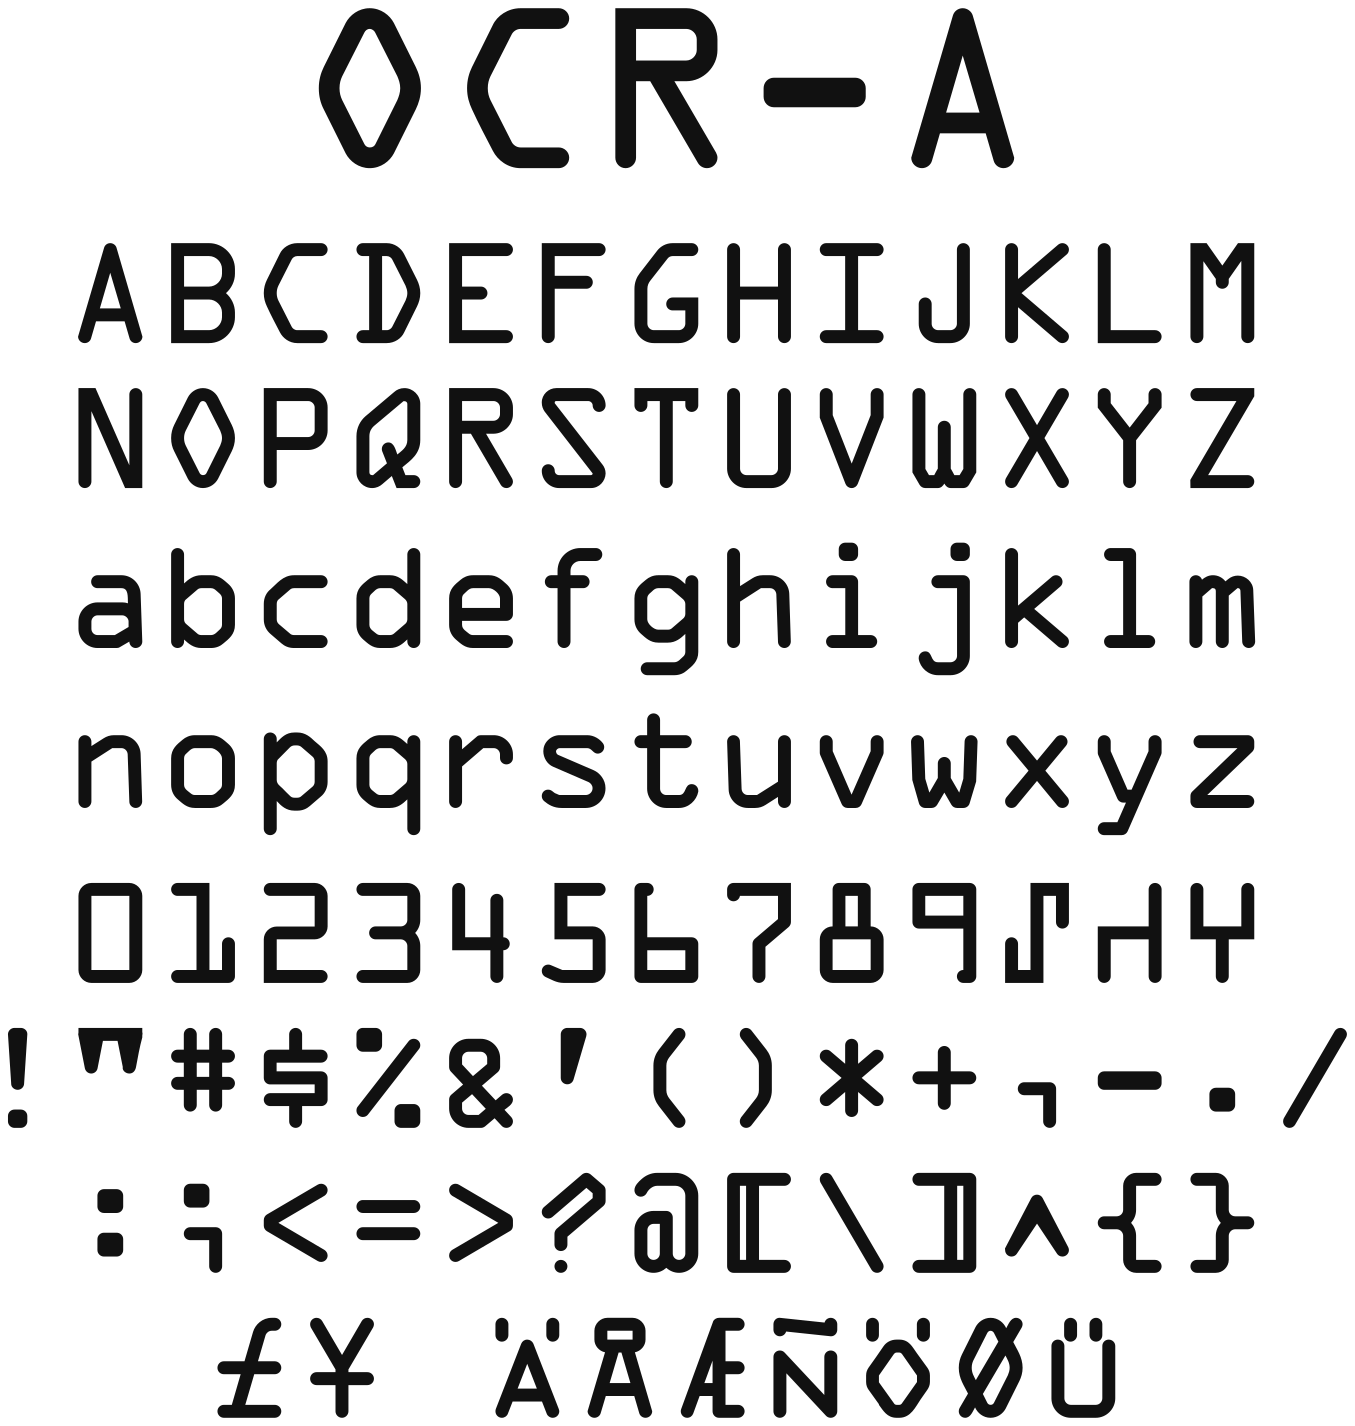
書体
- 書体名: OCR-A1。1968年ごろの日本の資料では「ISO-A」「ISO の A フォント」とも書かれている23
- 作り手: 米国の規格委員会 X3 の OCR の小委員会(X3.1、のちの X3A1)。規格書に個人の設計者の名前はない45
- 種類: OCR(Optical Character Recognition、光学式文字認識)の書体。機械の読み取りの効率を最大にするように作られた5
- 字数: 1961年の数字だけの版にはじまり、1966年に57字、1974年に86字、1977年に97字(米国の規格)6。国際規格 ISO 1073/I は69字1、JIS は62字7
- 規格: 米国は ANSI(American National Standards Institute、米国国家規格協会)の X3.17(1966年〜。最後の改訂は X3.17-1981)6。ヨーロッパは ECMA(European Computer Manufacturers Association、ヨーロッパ電子計算機工業会)の数字だけの ECMA-8(1965年)8。国際規格は ISO(International Organization for Standardization、国際標準化機構)の ISO R 1073-1969 にはじまり、ISO 1073/I-1976(ISO 1073-1)9。日本は1970年の JIS C 6250 にはじまり、いまは JIS X 9001(日本の規格を参照)
OCR-A は MICR(磁気インク文字認識)の書体ではないが、同じ時代に、機械と人の両方が読める文字として作られた10。MICR の書体 E-13B とは、数字の右端に縦の線を置いて読み取りの基準にするつくり(字形を参照)や、Unicode で記号が同じ区画に入っていること(文字の符号を参照)が共通する。MICR の仕組みと、同じ時代の機械が読む文字は MICR を参照。
開発の経緯
米国では、規格委員会 X3(データ処理)が1961年に OCR の小委員会 X3.1 を作り、OCR の文字セットの規格づくりを始めた4。X3 は ASA(American Standards Association、米国規格協会)の委員会で、OCR-A はこの年、まず数字だけの書体として作られた6。
1966年3月の米空軍ローマ航空開発センター(Rome Air Development Center)の報告書によれば、X3.1 は OCR 用の様式化した書体を作り、委員会の中では「TG1C」と呼んでいた。数字といくつかの記号の字はすでに決まり、大文字・数字・記号・句読点からなる2つ目の字の組は仕上げの途中だった。小文字は、商業上の用途が限られるため、規格にしようという動きはあまりなかった4。同じ報告書は、こうした字形を次のように評している4。
because of the specialized commercial interests that are represented, the character sets that have evolved are quite highly stylized, and are favored more by the machine than by the human. Nevertheless, the character sets that have resulted represent a usable compromise for applications where accuracy and economy are of more importance than human readability.
訳:特定の業界の利害を代表して作られたため、できあがった文字セットはかなり様式化されていて、人よりも機械に向いている。それでも、人の読みやすさよりも正確さと経済性が大事な用途では、使える妥協案になっている。
同じ1966年に、数字と4つの抽象的な字に大文字を加えた57字の英数字の版が出た。1981年の規格の序文は、これを ANSI X3.17-1966 と呼んでいる6。
その後の改訂は次のとおり6。
- 1974年(X3.17-1974): 小文字と、Character Space・Character Erase・Group Erase の3字を加えて86字。ピリオド・コンマ・疑問符・アポストロフィ・ハイフンの代替の字形を足し、分光の帯域・紙・文字の位置・印字品質の規定も広げた
- 1977年(X3.17-1977): 11字を加えて97字。すべての字に ASCII の符号の位置を割り当てた
- 1981年(X3.17-1981): 字の種類と字形は1977年版と同じ。文字の位置の規定を別の規格(X3.93M-1981)に分け、字形と公称の位置だけを残した
X3.17-1981 は1981年6月16日に承認された。幹事は CBEMA(Computer and Business Equipment Manufacturers Association、コンピューター・事務機器工業会)で、作ったのは X3 の小委員会 X3A1(OCR)、技術を担当したのはその作業部会 A(文字セットと字形)5。
米国の連邦政府は、FIPS(Federal Information Processing Standards、連邦情報処理規格)で OCR-A を採用した。1974年12月1日の FIPS PUB 32 は、OCR の文字セットを Style A(OCR-A)と Style B(OCR-B)の2つとした11。1982年6月25日の FIPS PUB 32-1 は、これを置き換えて ANSI X3.17-1981 をそのまま採用した12。FIPS PUB 32-1 は1996年5月29日に廃止された13。FIPS を出した NBS(National Bureau of Standards、米国標準局)の工作部門は、1981年の規格の原図を、中心線の作図の表記が正しくなるように直している5。
OCR-A が生まれた年や作り手は、資料によって書き方が異なる。
| 資料 | 年代・作り手の記述 |
|---|---|
| ECMA-8 第1版(1965年) | 1961年6月に ECMA の TC4 が OCR の標準化を開始。1964年5月に ISO で数字の案がまとまる8 |
| Greenly の報告書(1966年3月) | 1961年に ASA の X3 が OCR の小委員会 X3.1 を設置。候補の書体は TG1C4 |
| 関口茂「文字識別装置」(1968年) | ISO で提案されている A フォントは、米国の ASA の提案14 |
| ANSI X3.17-1981 の序文 | 1961年に米国で数字だけの書体として作られ、1966年に英数字の57字の版(X3.17-1966)6 |
| 小林章『欧文書体2』(2008年) | 「アメリカで1966年につくられた」15 |
| 『タイポグラフィ・ハンドブック』(2012年) | 1968年に開発され、「ANSIX3.4-1977 に基づき ATF から発表」16 |
| 高田雄吉『タイポグラフィ・ベイシック』(2018年) | 「USA Bureau of Standardsの開発による」17 |
| 『SF映画のタイポグラフィとデザイン』(2020年) | 「1968年にデザインされた」18 |
| Adobe Fonts の OCR A の説明 | 1968年に ATF(American Type Founders)が作った、米国標準局の基準を満たす最初期の OCR 書体の1つ19 |
| Monotype の OCR A Extended の説明 | 1966年の ANSI の基準に合わせて開発。デザイナーは「USA Bureau of Standards」20 |
| OCR-X の見本帳(2023年) | 1966年に ANSI の依頼で ATF が作った21 |
規格書(ANSI X3.17-1981 など)には、ATF の名前も、1968年のできごとも出てこない6。米国標準局(NBS)は、規格を FIPS として採用し、原図の作図を直した立場で、字形を作ったのは X3 の委員会である511。
規格になるまで
ヨーロッパでは、ECMA の TC4 が1961年6月に OCR の標準化を始めた。既存の文字セットを調べたうえで、様式化した数字の文字セット(Class A)と、ふつうの形の文字セット(Class B)の2つを作ることにした8。
ECMA は、様式化した文字セットの案を1963年11月にハーグの ISO/TC97/SC3 に出した。ISO の専門委員会 TC97(コンピューターと情報処理)の分科会で、OCR を扱っていた。ECMA も加わった ISO の2つの専門家のグループが、いくつかの案の妥協案をまとめ、1964年5月にニューヨークの ISO/TC97/SC3 で認められた。ECMA-8 はこの ISO の案にあたり、1965年4月30日に ECMA の総会で採択された。米国の BEMA(Business Equipment Manufacturers Association、事務機械工業会)とも緊密に協力している8。1966年の Greenly の報告書も、1963年から1964年にかけての合同の会議で、ASA のグループが作った数字の文字セットについて、ほぼ合意ができたと書いている4。
ECMA が規格にしたのは数字だけで、数字10字と、hook・fork・chair の3つの抽象記号、long vertical mark の14字2223。英数字の OCR-A は ECMA の規格にはない。
ISO では、この数字に同じ様式の大文字26字と記号18字を加えたものが、ISO 勧告 R 1073 に入った24。1968年の関口茂は、ISO で標準化が進んでいる OCR 用の字体について、米国の ASA から提案された A フォントは線分でできていてやや不自然だが、ヨーロッパの ECMA から提案された B フォントはかなり自然の形に近いと書いている14。
同じ論文によれば、日本の分科会(ISO-SC3規格委員会)も印字品質の討議に加わっていた14。
1972年の『OCRの導入と活用』は、ISO の推薦案の OCR-A を、英字26、数字10、記号3、垂線マーク1、貨幣記号3(¥ を含む)、特殊記号16、特殊文字7の66字からなるとしている。推薦案にはこのほか、OCR-A から数字10字・記号3・垂線マーク1を取り出した「OCR-A 数字サブセット」がある25。のちの ISO 1073/I は69字で、数え方が異なる1。
勧告 R 1073-1969 は改訂され、1976年12月1日に国際規格 ISO 1073/I(第1版)になった。1975年5月に加盟団体に回付され、日本・米国・英国・西ドイツ・フランスなど16か国が承認し、ブラジルが技術上の理由で反対した。OCR-B の ISO 1073/II とあわせて、R 1073-1969 を置き換えている9。数字のサブセットは、ISO 勧告案 No. 890 で勧告されたもの1。ECMA-8 も1977年1月の第2版で、ISO 1073 に合わせて編集を改めた(技術の内容は第1版と同じ)22。
ISO 1073/I の字形は、ISO の国別文字と通貨記号の9字も含めて、米国の規格と同じ。ただし、小文字と、1977年に米国の規格に加えた11字は、ISO にはない6。2000年の ISO の作業文書は、国際的に正式に標準化された書体は1960年代に OCR のために米国とヨーロッパで作られた2つだけで、OCR-A は米国で、OCR-B はヨーロッパで作られたとし、ISO 1073 には1993年まで変更の要望がなかったと書いている26。ISO 1073-1 は廃止されておらず、DIN Media の規格の一覧では、いまも有効(Current)とされている27。
日本の規格
日本の規格は、1970年6月1日に制定された JIS C 6250「光学式文字認識のための字形(英数字)」。1976年11月1日に改正され、1987年3月1日に JIS X 9001 に移った28。いまも有効な規格で、最近の確認は2024年6月20日29。
1つの規格で OCR-A と OCR-B の2つを定めている30。
JIS の OCR-A は、数字・英大文字・記号の62字7。小文字はなく、ISO の見本にある国別文字(Ä Ö Ü Æ Ñ Ø など)も、JIS の見本にはない31。4つの特殊記号は「かぎ」「つの」「いす」(抽象記号)と「分離記号」と呼び、消去記号は「字抹消記号」「行抹消記号」と呼ぶ31。
印字品質は別の規格になっている。1982年の『文字認識概論』の表では、印字品質の規格は ISO 1831(1971年、1980年改訂)と JIS C 6253(1975年、1982年改正)32。1983年の JIS X 9004(光学式文字認識のための印字仕様)は、字形の規格を「JIS C 6250」と呼んでいる33。
字形
ANSI X3.17-1981 は、OCR-A の目的を、機械も人も読める標準の文字セットで、OCR の読みやすさを最適にしたものとし、一般の用途にも使えるとしている10。
字形は、線の中心線と、公称の線幅で決める1034。JIS はこれを「心線字形」と呼び、「字の骨組みを表す線描きの字形」と定義している30。どの線も同じ太さで、寸法は、字わくの高さ H・幅 W・線幅 T に対する比(1/8 W、3/8 H など)と、角の半径(r1〜r6)で表す35。
- 字形に鋭い角があるところは、印字もできるだけ鋭くする。ただし、印字の角の半径は 0.004インチ(0.10 mm)より小さくなくてよい(ISO・ECMA は 0.08 mm)110
- ISO は、半径の指定のない縁もなめらかにつなぎ、角を丸めるとしている36
- 活字の作り方は規定しない。印字装置のにじみやゆがみから逆に考えて、活字を設計する10
1970年の『電子計算機入力のための文字・図形の自動認識』は、OCR-A を「9×5 の格子状文字わくに表現された文字」と説明している37。
1965年の坂井利之の論文は、OCR-A の数字が、機械が読み取るときのタイミングを取りやすいように工夫されていると説明している。高さの方向を上下2つの帯に分けて数字10字と記号4字を見分けやすくし、右端には E13B と同じように、必ず縦の線が上か下にある38。
線はふつうの文字よりかなり太く、縦の線を取り出しやすく、駆動の速さのむらにも強い。ただし、英大文字まで広げたものでは、こうした特徴を保てていない38。
形の似た字は、はっきり区別できるようにした。1966年の報告書は、候補の書体 TG1C で、B と 8、I と 1、5 と S、O と 0 に明確な違いを付けたと書いている4。

それでも、同じ用途の中で使わないほうがよい組み合わせがある。ANSI X3.17-1981 は、fork と Y・V、! と丸括弧、# と & を挙げている39。ISO 1073/I も、Y と fork を同じ用途で使わないよう勧めている34。
OCR-A には、制御用の記号として、long vertical mark・chair・fork・hook の4つの特殊記号がある39。
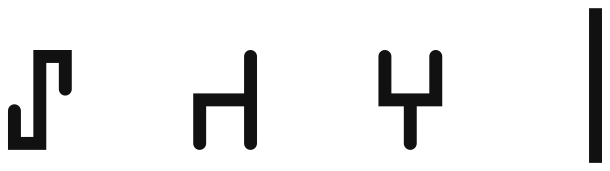
- hook・fork・chair は、ISO では抽象記号(abstract symbols)と呼ぶ34
- hook・fork・chair は、決まった意味を持たない記号で、規格は、制御用の記号が必要なところで使うよう勧めているだけ39。帳票の中で、欄の始まりや種類を読取装置に知らせる印として使い、どの記号を何に使うかは用途ごとに決める。たとえばドイツの小切手では、hook を小切手番号、chair を IBAN、fork を金額に添える(使われ方を参照)40。ASCII の文字セットの中では、Tilde・Underline・Grave Accent の代わりとしても使える41
- long vertical mark は、おもに欄の区切りに使う。高さの上限はなく、帳票の上から下まで罫線として刷っておくこともある39。最小の長さは字の高さの 14/9 倍1
代替の字形と、消去記号・小文字は次のとおり。
- ピリオド・コンマ・疑問符・ハイフン・アポストロフィには、2つの形がある6。ピリオド・コンマ・疑問符の代替の形は、高速で印字したときに紙を突き抜けないよう、小さい印字の面積を使わない形。ハイフンとアポストロフィは、見分けやすさと突き抜けの問題から新しい形を作り、古い形を代替にした42
- Character Erase(字抹消記号)はサイズ I だけにあり、単独でも、ほかの字に重ねても検出できる。Group Erase(行抹消記号)は、字の高さの 1/6〜5/6 にかかる長さ 0.300インチ(7.62 mm)以上の連続した線39。FIPS PUB 32 は、Character Erase を、全体が塗られた面積だけでほかの字と見分けられる字としている43
- 小文字はサイズ I だけにあり、図面の寸法は1,000分の1インチで書かれている。i・j・m・p・w は公称の字わくをはみ出す10
サイズと印字の仕様
OCR-A には、用途ごとに3つの大きさがある。
| サイズ | 字幅 W | 字高 H | 線幅 T |
|---|---|---|---|
| I | 1.40 mm(0.055 in) | 2.40 mm(0.094 in) | 0.35 mm(0.014 in) |
| III | 1.52 mm(0.060 in) | 3.20 mm(0.126 in) | 0.38 mm(0.015 in) |
| IV | 2.04 mm(0.080 in) | 3.80 mm(0.150 in) | 0.51 mm(0.020 in) |
- サイズ I: 高速のラインプリンターやタイプライター
- サイズ III: 金銭登録機(キャッシュレジスター)や会計機。ジャーナルテープ用の22字
- サイズ IV: エンボス加工したプラスチックのカードや金属板からの印字
寸法は ECMA-8・ISO 1073/I の mm と、ANSI X3.17-1981 のインチ(in)による2244。用途は ANSI X3.17-1981 の付録による45。サイズ IV は、ECMA の1968年の規格では、おもにクレジットカードの印字のためのもの46。サイズ III のジャーナルテープ用の22字は、数字10字、C・E・N・S・T・X・Z、+ < >、long vertical mark、Character Space39。
1965年の ECMA-8 第1版には、サイズ II(字幅 1.40 mm、字高 2.84 mm、線幅 0.35 mm)もあった8。サイズ II はヨーロッパで作られたもので、米国では使われず、規格にも含めていないが、名前は国際的な用途のために残している45。1982年の『文字認識概論』は、あまり使われないという理由で削除されたと書いている7。ECMA の単一行の帳票の規格(ECMA-18)も、1977年の第2版でサイズ II をサイズ IV に置き換えた47。
印字の仕様の主なもの(米国の規格と FIPS PUB 32)は次のとおり。
- 行の間隔: 1インチあたり、サイズ I は6行(小文字を使うときは5行)、III は5行、IV は4行48
- 文字の間隔: サイズ I・III は 0.090〜0.180インチ(2.29〜4.57 mm)、IV は 0.130〜0.260インチ。1インチに10字なら、字送りは 1/10インチ3948
- 余白: 0.250インチ(6.35 mm)以上49
- 文字の傾き: 3度まで50
- インキ: 読ませるインキは、カーボンブラックを含む反射率の低いもの。反射率は18% 未満が望ましく、40% を超えてはならない。読ませない(機械が見ない)インキは、赤系と青系の2色51
印字品質は、ECMA-15 と JIS X 9004 が2つの範囲(X: 高品質、Y: 中品質)を定め、文字と紙のコントラスト(PCS、Print Contrast Signal)などで測る52。1972年の電子技術総合研究所の山崎一生の報告は、OCR の性能の評価のために、印字品質を数量で評価する方法を論じ、ラインプリンターで印字した OCR-A の数字で試している(公称の線幅は 0.35 mm)53。
読み取り
OCR-A は、字が決まった位置の線分でできているので、所定の位置に線(ストローク)があるかどうかを数える方法(ストローク分析)で読める。1968年の関口茂は、この方法を、ISO の A フォントや Farrington の Selfcheck の文字のような、単純な線分でできた字を読む装置に使われる方法として紹介している3。1974年の『電子計算機概論』も、OCR-A はこの方法に有効なように設計されていて、字を作る線の組み合わせで字を符号として表せると説明している54。
1982年の『文字認識概論』は、OCR-A を、ストロークアナリシス(線の分析)を意識した線素の構成で、人の目にはやや不自然さが残るが、OCR では単純な回路でも高い読取精度が期待できる字形と説明している7。
1968年の玄地宏は、こうした機械が成り立つのは、字そのものが線素でできているからだと書いている55。同じ論文は、各社が自社の書体とそれを読む OCR を作る行き方(Farrington・GE・IBM・NCR・RCA)に対して、ISO-A のフォントを、国際的に統一しようという運動と位置づけ、利点と問題点を挙げている5657。
利点として、各文字が機械認識に適した一種の符号なので、読取装置が簡単になり、誤読も少なくできることを挙げる。一方で、専用のタイプライターが要り、読みやすさに問題があり、慣れない人の手に渡る書類では抵抗があるだろうとしている57。
同じ論文の「現在試作ならびに市販されている OCR」の表には、ISO-A を読む装置として次のものが載っている(N は数字、AN は英数字)2。
| 装置 | 読む書類 | 読む字体(表の記載) |
|---|---|---|
| 東芝 | ジャーナルテープ | ISO-A/B、東芝形字体、IBM 1428、Farrington 12F、NCR(N) |
| 日電 | ジャーナルテープ | ISO-A、NCR(N) |
| CDC-Rabinow 915 | ページ | ISO-A(AN) |
| Farrington 3040 | — | NCR、ISO-A ほか(N) |
| Farrington 3020 | カード | Farrington 7B・12F、ISO-A、IBM 1428(N)。クレジットカードの複写 |
| IBM 1287 | — | Farrington 7B、IBM 1428、ISO-A(N)、手書きの数字 |
| Optical Scanning OpScan 288 | — | ISO-A(N)、手書きの数字 |
1965年の坂井利之の論文は、ドイツの郵政省が読み取りを調べた書体 CZ 13 を「OCR-A と同系統のもの」としている58(調査の結果は E-13B を参照)。
日本のメーカーも、OCR-A を読む装置を販売していた。1969年の『情報科学』の周辺装置の性能の一覧表は、富士通の光学文字読取装置 FACOM 6300A の性能を「約1,100枚/分 ISO OCR-A活字,マーク読取」としている59。1975年の日立製作所の光学文字読取装置の広告は、手書き文字を読む H-8959 について、「活字ならアルファベットも全部読みます」とし、読める活字を OCR-A と OCR-B としている60。
OCR-B との違い
米国の OCR-B の規格 ANSI X3.49-1975 の序文によれば、機械で印字する OCR の標準の文字セットは OCR-A と OCR-B の2つで、OCR 用の字形では、ふつうの見た目と読み取りの性能を引き換えにできる。OCR-A の数字と大文字は読み取りの性能を、OCR-B はふつうの見た目を重んじていて、利用者がどちらかを選べるようにしている61。FIPS PUB 32 も、Style A(OCR-A)を「機械の読み取りの効率を最大にする」書体、Style B(OCR-B)を見た目を重んじた書体としている11。
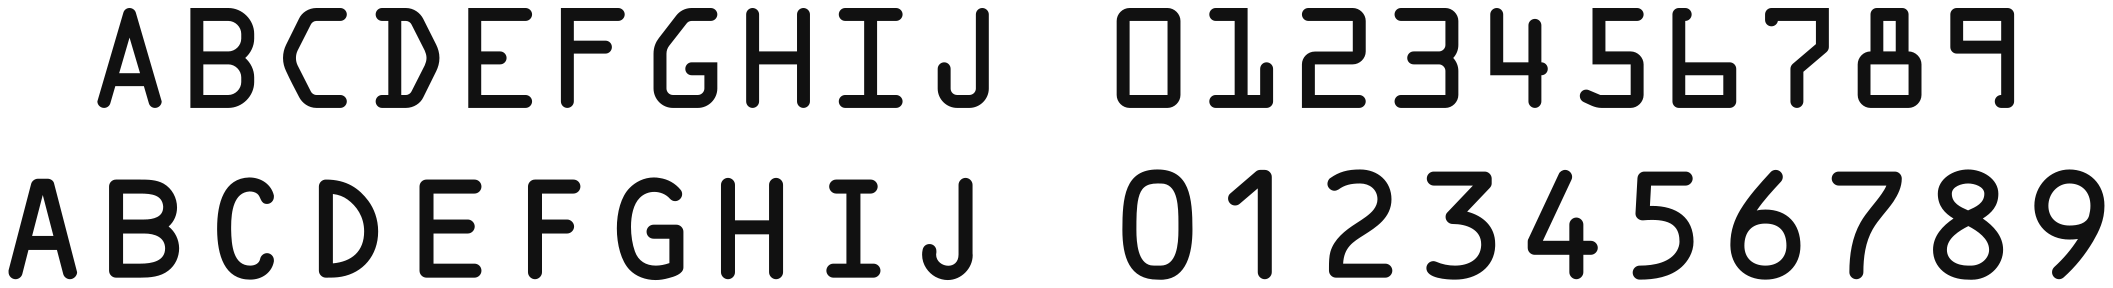
日本では OCR-B が多く使われた。1977年の『流通とシステム』の比較の表は、OCR-A を、それまでの光学文字読取りの技術の求めに応じて、機械に読みやすいよう変形した字体とし、OCR-B を、読みやすさを確保しながら美しさも満たし、一般の事務にも使えることをめざした字体としている62。
同じ表は、商品のイメージとして、OCR-A は「フォント体が直線的で,対消費者表示には適当でない」、OCR-B は「フォント体が曲線的で通常目にする活字に近く,対消費者表示に適している」とし、米国が OCR-A で統一しようとしているのに対して、日本は OCR-B の市場が多く、統一伝票にも採用していると書いている62。1982年の『文字認識概論』も、OCR-B を「OCR 用として最も標準的な字形」としている7。
OCR-B は、OCR-A の改良版ではなく、ヨーロッパが別に出した案だった。ECMA は1961年の時点で、様式化した文字セット(Class A)と、ふつうの形の文字セット(Class B)の2つを作ると決めていた8。OCR-B は ECMA とアドリアン・フルティガーが共同で開発し、1968年に発表された15。フルティガーは、問題を分析するところから始め、制作には全部で5年かかったと話している63。
米国の小売業が値札に OCR-A を選んだ(使われ方を参照)のは、時期の違いもある。1988年の『欧米流通情報革命の現場を行く』は、当時は OCR-B が費用と技術の面で OCR-A に明らかに劣っていたとし、OCR の技術が発達した時期に OCR-B を選んだ日本とは背景が異なると書いている64。
バーコードの下の数字に OCR-B が使われることは、MICR を参照。
使われ方
ISO 1073/I は、OCR-A・OCR-B の3つのサイズが関わる装置と印刷の方法として、タイプライター、金銭登録機、ナンバリングの機械、高速プリンター、クレジットカードのインプリンター、ノンインパクトのインプリンター、活版印刷、オフセット印刷を挙げている1。
米国では、OCR-A が小売業の値札の標準になった。NRMA(National Retail Merchants Association、全米小売商協会)は、メーカー各社から出された仕様の中から、1973年11月に OCR-A を選び、1974年11月にその基準が公開された65。1975年の『流通とシステム』によれば、NRMA の分科会 MITF が1974年10月に UVM(Universal Vendor Marking、統一ベンダー・マーキング)を決め、表示の文字を OCR-A のサイズ I(記事の表記では「規格 ANSI×3A/73−110」)とした66。1977年の『季刊輸送展望』は、採用が決まったのを1974年の春としている67。
同じ記事は、OCR-A を選んだ理由として、値札を作る機械を改造して使えること、小さな値札にできること、メーカーが商品に付けるソース・マーキングができること、機械でも人でも読めること、売場で価格を変えやすいことの5つを挙げている。使う字は、OCR-A のサイズ I の25字(数字10字と、R P M $ C D U N A ・ > ⑂ / X Y)66。1983年の『流通業のPOS読本』は、当時は OCR-A だけが米国の標準化局の認定した方式だったと書いている65。
ただ、1978年の時点で OCR-A の値札に本格的に踏み切っていたのは、シアーズと J.C.ペニーだけだった。コダックのフィルムにも OCR-A の値札が付いていた68。シアーズは1971年から POS を使っていた67。1988年の『欧米流通情報革命の現場を行く』は、NRMA の OCR の値札は、次第に UPC 型のバーコードに替わっていると書いている64。
J.C.ペニーとシアーズのクレジットカードは、値札と同じ OCR-A で口座番号を表示していた69。
エンボス加工したカードの数字は、いまも OCR-A を使える。ISO/IEC 7811-1:2018 は、カードから直接、あるいはカードの写し(インプリント)から機械で読むエンボスの文字には、OCR-A(サイズ I と IV)、OCR-B(サイズ I と IV)、Farrington 7B のどれかの数字を使うとしている70。
OCR を使う書類の多くは、中央で作って外に出し、記入されて戻ってくるターンアラウンド方式のもの。1968年の玄地宏は、ラインプリンターで作った伝票が、注文伝票・料金の徴収・電気やガスの検針などに広く使われ、実用の OCR システムの大部分がこの形だと書いている71。
タイプライターで打った書類を読む使い方もあった。1972年の『OCRの導入と活用』は、米国ペンシルベニア州ピッツバーグの「M」信託銀行が、個人の貸付の伝票を OCR で読むようにした例を紹介している。それまではキーパンチで、申込みからコンピューターで処理するまでに24時間ほどかかっていた。各支店の貸付係が、OCR-A(ANSCSOCR-A)のフォントを付けたタイプライターでデータシートを打ち、本店でページリーダーにかける。誤りはその字だけを消して打ち直せばよく、現場の評判がよかったという72。
OCR-A は、いまも請求書の振込票に使われている。カナダのナショナル銀行の自動ロックボックス(支払いの受付の代行)の仕様書は、各票の下端に、顧客番号や金額などを OCR-A(ANSI X3.17-1981)で印字するよう求めている73。フリーのフォントの作者 John Sauter も、ロックボックスの会社が支払いを処理するための振込票に、OCR-A がいまも商用で使われていると書いている74。
ドイツでは、小切手の機械で読む行に OCR-A を使う。ドイツの銀行業界団体 Die Deutsche Kreditwirtschaft の「統一支払用紙の指針」(2016年)は、すべての小切手の下から3行目(コード行)を、DIN 66008-1 の OCR-A1 の字だけで刷るとし、小切手番号には hook(Haken)、IBAN には chair(Stuhl)、金額には fork(Gabel)を添えるとしている40。
本の ISBN については、資料によって書体が異なる。デジタルフォント OCR A の作者 Matthew Skala は、OCR-A を本の ISBN に使われる書体、OCR-B を UPC・EAN のバーコードの数字に使われる書体と説明している75。一方、米国の書籍業界の団体 BISG(Book Industry Study Group、米国書籍業界研究グループ)のいまのガイドラインは、バーコードの上の ISBN の文字を、OCR-B や Arial などのサンセリフ体としている76。日本では、日本図書コード管理センターの利用の手引きによれば、かつては本の裏表紙の日本図書コード(ISBN と分類記号・価格を並べた文字の行)を OCR-B で表し、レジなどで読み込ませていた。いまは2段のバーコード(書籍 JAN コード)で読み取り、バーコードの下の添え数字は JIS に準拠した OCR-B で作る。一方、文字の行の日本図書コードは、処理の機器に不具合を起こすおそれがあるので、OCR-B で表記してはならない77。
文字の符号
1969年の ECMA-19(MICR と OCR の文字の符号)は、OCR-A の数字を 0〜9 の位置(7ビットの符号で 3/0〜3/9)に、hook を 3/12、fork を 3/13、chair を 3/14 に割り当てた78。ISO 2033-1983 も同じで、long vertical mark を 7/12 に置き、消去記号は DEL にあたる79。fork は Y と紛れるおそれがあるので、ふつうは英字とは一緒に使わないとしている79。日本の JIS X 9010(1984年。当初の番号は JIS C 6229-1984)も、OCR-A の図形文字集合を定めている80。この日本の集合は、1985年8月1日に国際登録簿に ISO-IR-91「Japanese OCR-A Graphic Character Set」として登録された。ISO 2033 の英数字の表(表3)の 5/12 に円記号(¥)を加えた59字で、英数字の表では、hook を 3/12、chair を 3/14、fork を 5/13、long vertical mark を 7/12 に置いている81。
米国の規格は、1977年の改訂で、すべての字に ASCII の位置を割り当てた6。ANSI X3.17-1981 は hook・fork・chair を Tilde・Underline・Grave Accent の位置に置くが39、1974年の FIPS PUB 32 は hook を Underline、fork を Grave Accent、chair を Tilde の位置としていて、割り当てが異なる82。
Unicode では、「Optical Character Recognition」のブロック(U+2440〜U+245F)の「OCR-A」の見出しの下に、6字がある。Unicode 1.1 から83。
| 符号 | 字 | 名前 |
|---|---|---|
| U+2440 | ⑀ | OCR HOOK |
| U+2441 | ⑁ | OCR CHAIR |
| U+2442 | ⑂ | OCR FORK |
| U+2443 | ⑃ | OCR INVERTED FORK |
| U+2444 | ⑄ | OCR BELT BUCKLE |
| U+2445 | ⑅ | OCR BOW TIE(別名 unique asterisk) |
続く U+2446〜U+2449 は、E-13B(MICR)の4つの記号(E-13B を参照)83。IBM の文字の ID の表も、inverted fork・belt buckle・bow tie(unique asterisk)を OCR-A の字として載せている。一方、long vertical mark・Character Erase・Group Erase には Unicode の符号がない84。inverted fork・belt buckle・bow tie の3字は、ANSI X3.17-1981 の字形の図にはない39。
タイプライター・プリンター
IBM の電動タイプライター Selectric(セレクトリック)の1970年の書体見本には、「USASI OCR」(Code 056、10ピッチ)の活字ボール(エレメント)が載っている。見本の文は「THIS IS A SAMPLE OF IBM USASI OPTICAL CHARACTER RECOGNITION TYPE- IT MEETS SPECIFICATIONS OF THE UNITED STATES OF AMERICA STANDARDS INSTITUTE-」。特殊記号の並びを変え、テンキーの配列の数字をなくした「Communications OCR」(Code 091)もあり、どちらも特殊用途の書体とされている85。1966年の Greenly の報告書には、ローマ航空開発センターが候補の書体のサイズ X のタイプライターを買ったとある4。
ラインプリンターでは、IBM 3203 プリンター Model 5 の1979年の解説書が、48字の OCR-A を5組並べた印字チェーン(トレイン)「OAA」や、OCR-A の数字を含むトレインを挙げ、OCR-A と OCR-B で印字した例を載せている86。
市販のデジタルフォント
市販のデジタルフォントには次のものがある。
- Adobe「OCR A Std」: Adobe Fonts で使える(OCR A Std を参照)
- Linotype「OCR A」: 販売サイトでは「USA Bureau of Standards」の設計としている。同じページの書体の説明は、OCR-B のもの(ECMA とフルティガー)になっている。MyFonts で販売している87
- Bitstream「OCR-A」: 説明は「A set of capitals adequate for machine reading only; this barely legible pioneer sees declining use.」。MyFonts で販売している88
- URW「OCR-A M」: 販売サイトはデザイナーを「British Standards Institute」としているが、Luc Devroye は URW++ が作ったものだろうとしている。MyFonts で販売している8990
- Monotype「OCR A Extended」: Microsoft の製品に付く版。Microsoft の製品のほかで使うときのライセンスは、Monotype が扱っている91(OCR A Extended を参照)
OCR A Std(Adobe)
Adobe の版で、Adobe Fonts で使える。Adobe の説明では、ANSI X3.17-1981 のサイズ I に従い、ドイツの DIN 66008 も同じ字形を定めているという。ISO-Adobe の文字セットを収めた代替の版もある19。
- 著作権表示: 「© 1988, 2002 Adobe Systems Incorporated. All rights reserved.」92
- デザイナーの欄: 「American Type Founders staff and Adobe Type staff」92
- バージョン: Version 2.06492
- 文字: 261字。hook・chair・fork(U+2440〜U+2442)と、アクセント付きの字などを収める。字幅はすべて同じ92
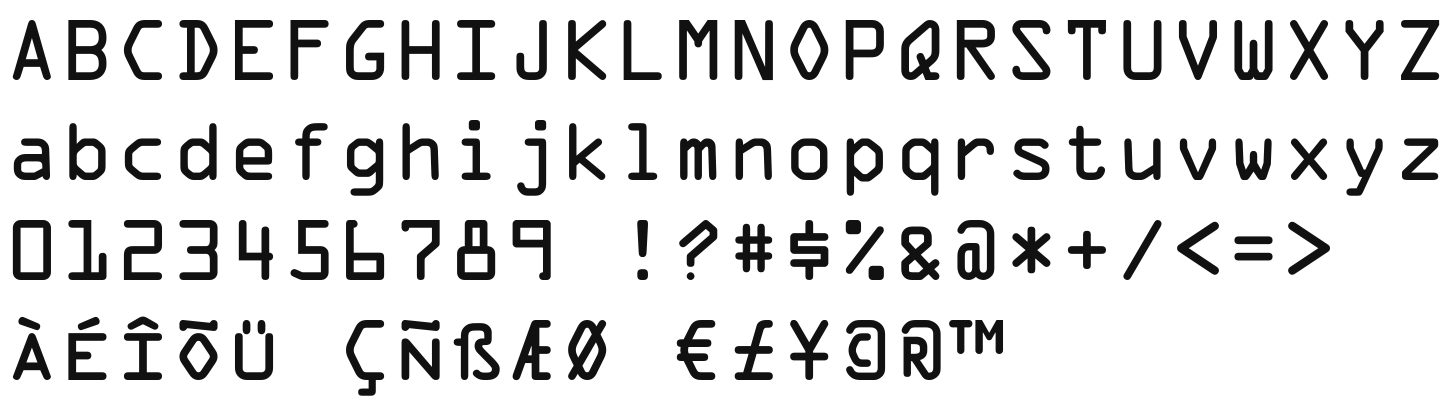
フォントのデザイナーの欄に ATF の名前があるのは、Adobe Fonts の説明の「1968年に ATF が作った」と同じ主張である。ただ、OCR-A の規格書には ATF の名前は出てこず、ATF が作ったという説は、Adobe などの説明でしか確かめられない(開発の経緯を参照)。
OCR A Extended(Monotype)
Monotype の版で、Microsoft の製品のフォントとして配られている。Microsoft の説明は「Optical Character Recognition face extended to the regular Win Ansi character set.」(OCR の書体を、Windows のふつうの文字セットに広げたもの)91。Microsoft のフォントの一覧では、Office の製品のフォントとして載っている93。Monotype は、その「techno」な見た目から広告やディスプレイに再発見されたと説明している20。
- ファイル名: Ocraext.ttf91
- 著作権表示: 「Digitized data copyright The Monotype Corporation 1991-1995. All rights reserved.」9194
- バージョン: Version 1.8094
- 文字: 248字。英大文字・小文字・数字のほか、アクセント付きの字や €・™ などの Windows の文字セット(コードページ 1252)の字を収める9194
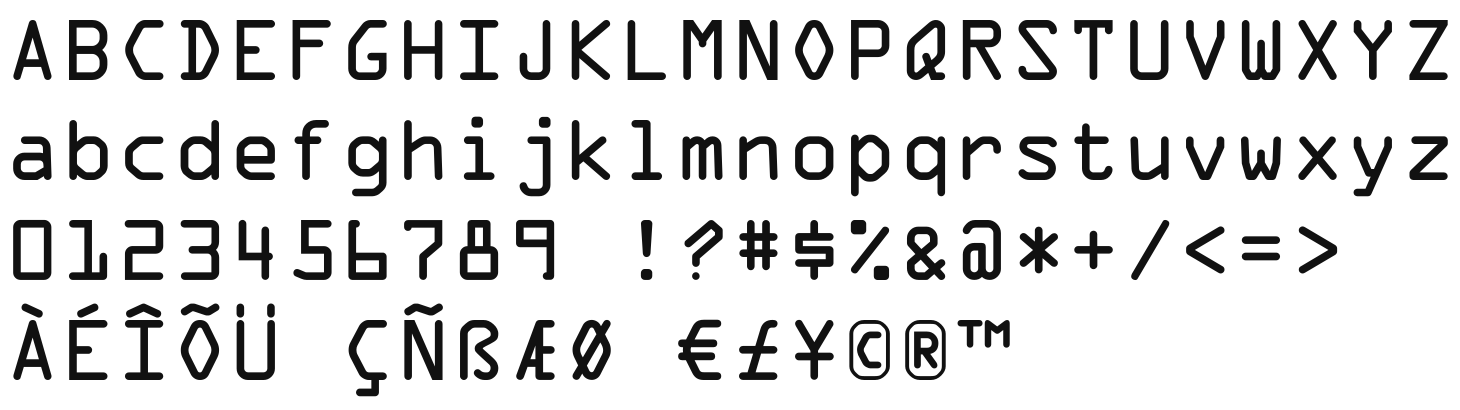
文字セットを広げた一方で、OCR-A の hook・chair・fork は入っていない(Unicode の U+2440〜U+2442 にも、別の位置にもない)。248字の字幅はすべて同じだが、フォントの等幅の設定はなく、Microsoft の一覧でも「Fixed pitch」は False になっている9194。
フリーのデジタルフォント
フリーのフォントは3つあり、どれも ANSI X3.17-1977 から起こした METAFONT のデータが元になっている749596。
METAFONT は、Donald E. Knuth が組版のソフト TeX と一緒に作った、字の形をプログラムとして書くための言語と、その処理系。最初の版は1977〜1978年に作られ、1983〜1985年に、いま使われている版に作り直された(Lillqvist のソースにある「METAFONT84」は、この新しい版のこと)9798。字の形の定義から、出力する機器の解像度に合わせたビットマップのフォントを作る99。OCR-A のように、線の中心線と線の太さで決める字は、ペンで線をなぞる METAFONT の書き方と相性がよい。
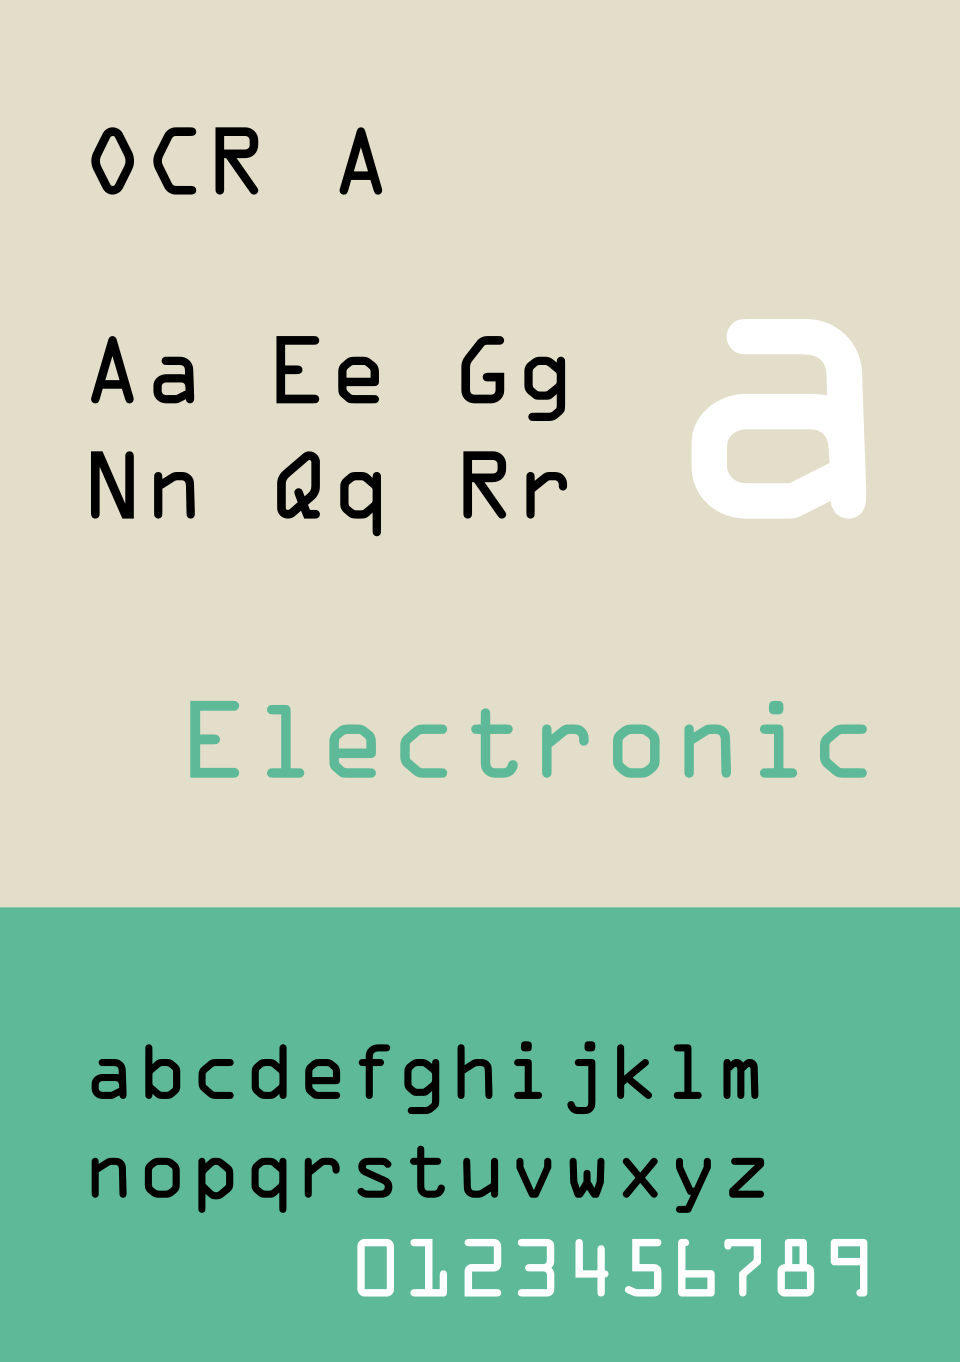
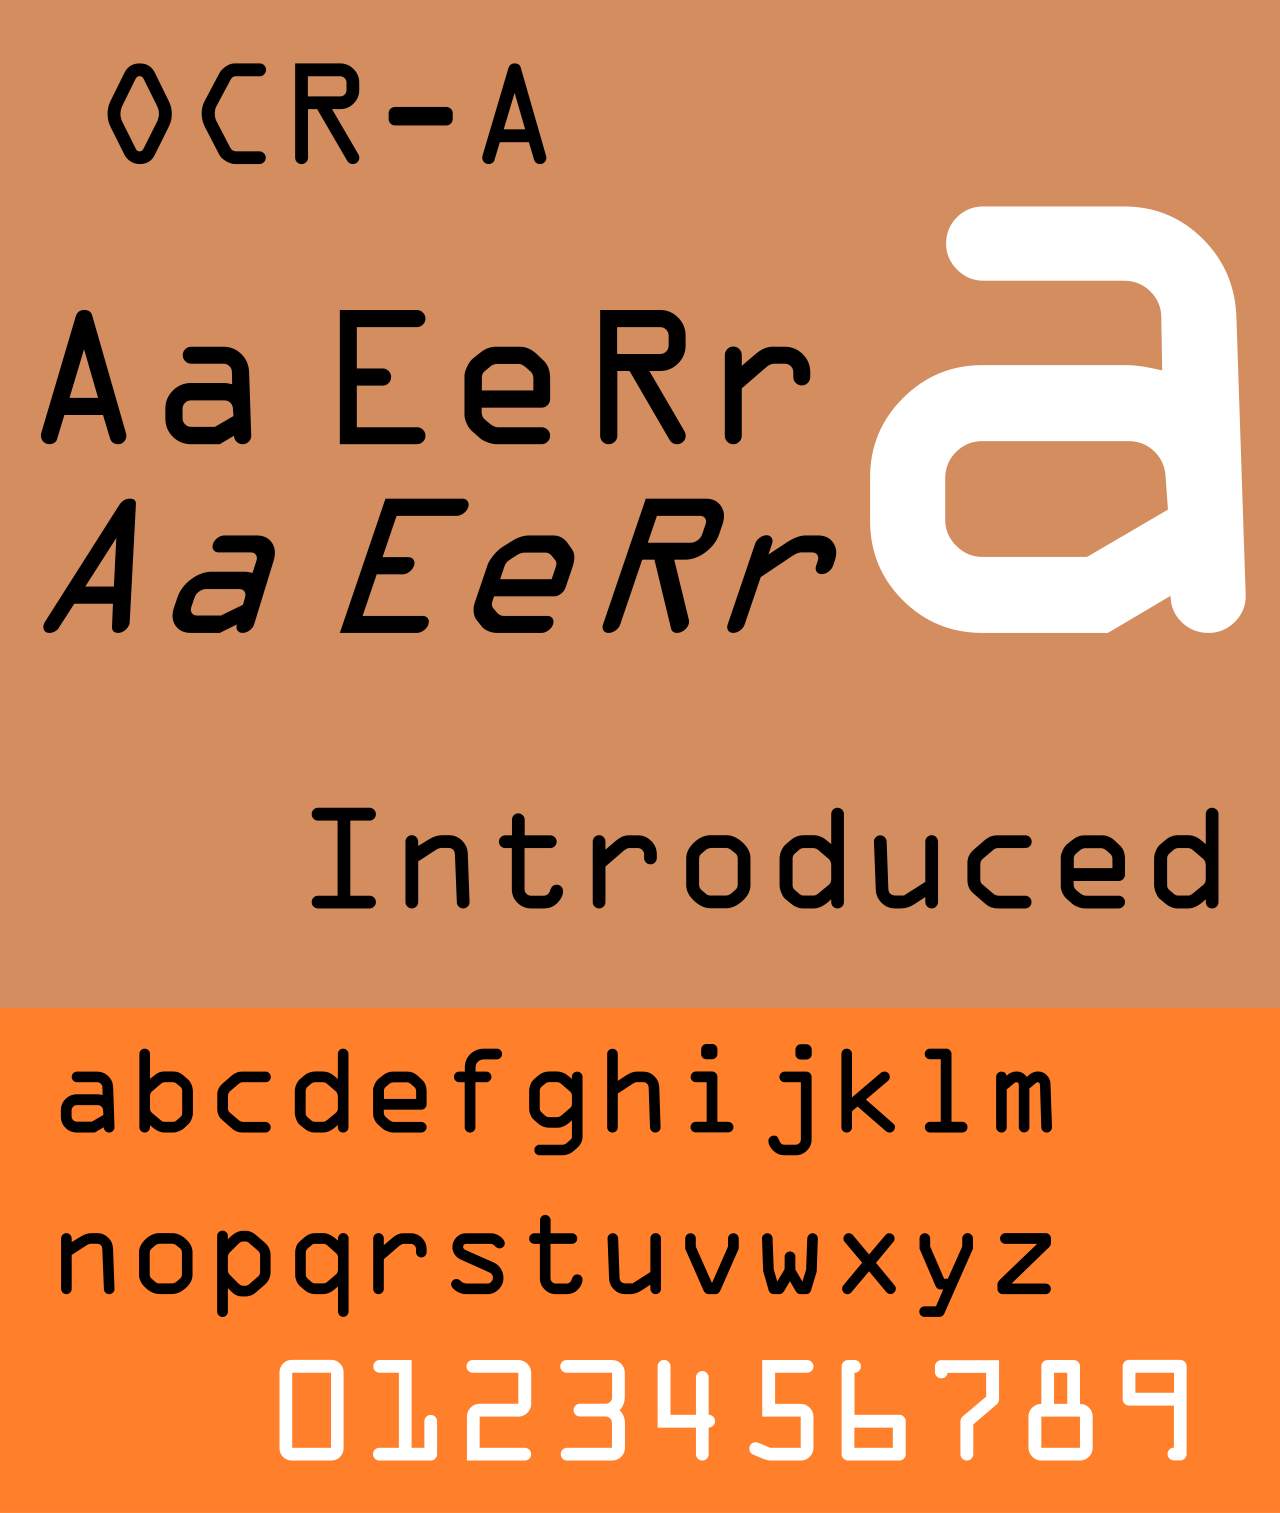
3つのうち、いま使うなら、縁がなめらかで、形と送りが METAFONT の元のデータとほぼ同じ Skala の版がよい(5つのフォントの違いを参照)。冒頭の見本などの図も、Skala の版で作った。
ocr-a(Richard B. Wales)
TeX で使う METAFONT のフォント。フィンランド技術研究センター(VTT)の計算機部門にいた Tor Lillqvist が、1969年の ISO 勧告 R 1073 をもとに作ったものを、1988〜1989年に、カリフォルニア大学ロサンゼルス校(UCLA)のコンピューター科学科にいた Richard B. Wales が、ANSI X3.17-1977(1977年1月20日承認)に合わせて作り直した959698。Lillqvist は、のちに画像編集ソフト GIMP と、それが使う GUI のツールキット GTK+ を Windows に移植したことで知られる100。CTAN で配布されている101。
- ライセンス: ソースの著作権表示とクレジットを残し、配布に複製・通信の実費を超える料金を取らなければ、何をしてもよい。CTAN の区分は「Do Not Sell Except by Arrangement」95101
- 規格にない Tilde・Underline・Grave Accent・Vertical Bar の4字は、ASCII の文字セットをそろえるために Wales がデザインした95
OCR-A(John Sauter)
John Sauter が2004年に SourceForge で公開した TrueType と PostScript のフォント74102。METAFONT のデータを、フォント編集ソフトの FontForge と、ビットマップの輪郭をなぞるソフトの potrace を使って TrueType と PostScript にし、字に Unicode の符号を割り当てた。規格書を買って比べたところ、完全に一致したという74。
- ライセンス: パブリックドメイン102103
- 作者は、OCR-A のサイトライセンスがとても高いので、フリーのフォントを作ったと書いている。2020年の追記では、ファイルに問題があれば Matthew Skala の版を勧めている74
- Luc Devroye は、TrueType のファイルに問題を見つけ、2008年に、Sauter の著作権表示を残したまま、同じ FontForge で TrueType・OpenType・Type 1 の形式に作り直した104。字の形は元のファイルとほぼ同じで、元のファイルでは 0 になっていた行の高さの値(hhea の ascent・descent)と、z の字の名前(元は enc-122)が直っている105
OCR A(Matthew Skala)
カナダのコンピューター科学者 Matthew Skala が、Wales の METAFONT のデータを MetaType1 に移して作ったフォント。Skala は、2010年に始めた METAFONT による日本語のフォントのプロジェクト「Tsukurimashou」の作者でもあり、2013年の論文の所属はマニトバ大学のコンピューター科学科106。TrueType・PostScript・OpenType の形式がある。2006年に出した版は古くなり、いまの版は2011年に Wales の版から改めて起こしたもの7596。
- バージョン: Version 2(2021年)。フォントの中にライセンスの記載はない107
- ライセンス: 配布のページは、商用を含めて自由に使えるとし、Skala 自身の手を入れた部分はパブリックドメインとしている75。ただし、元にした Wales のデータには、配布で料金を取らないという条件があり、Skala もソースの冒頭で、その著作権表示が当てはまるかもしれないと書いている108
- ASCII の字のほか、£ ¥ と国別文字(Ä Å Æ Ñ Ö Ø Ü)、hook・chair・fork(U+2440〜U+2442)を収めている。5つの代替の字形は、OpenType の機能 ss01〜ss05 で切り替わる107
- Tilde・Underline・Grave Accent・Vertical Bar の4字は、Wales がデザインした字を受け継いでいる108(冒頭の見本には入れていない)
Skala は、このフォントの雰囲気を次のように書いている96。
It has an old-fashioned computerish feel, evoking the mythos of “big iron” data processing for which it was originally designed.
訳:古風なコンピューターらしい雰囲気があり、この書体がもともと作られた、「ビッグアイアン」(大型の計算機)によるデータ処理の時代の神話を思い起こさせる。
5つのフォントの違い
Wales・Sauter・Skala の3つは、同じ METAFONT のデータから作られていて、字の骨組みは同じ。市販の OCR A Std・OCR A Extended も、並べると字の骨組みはほぼ変わらない。
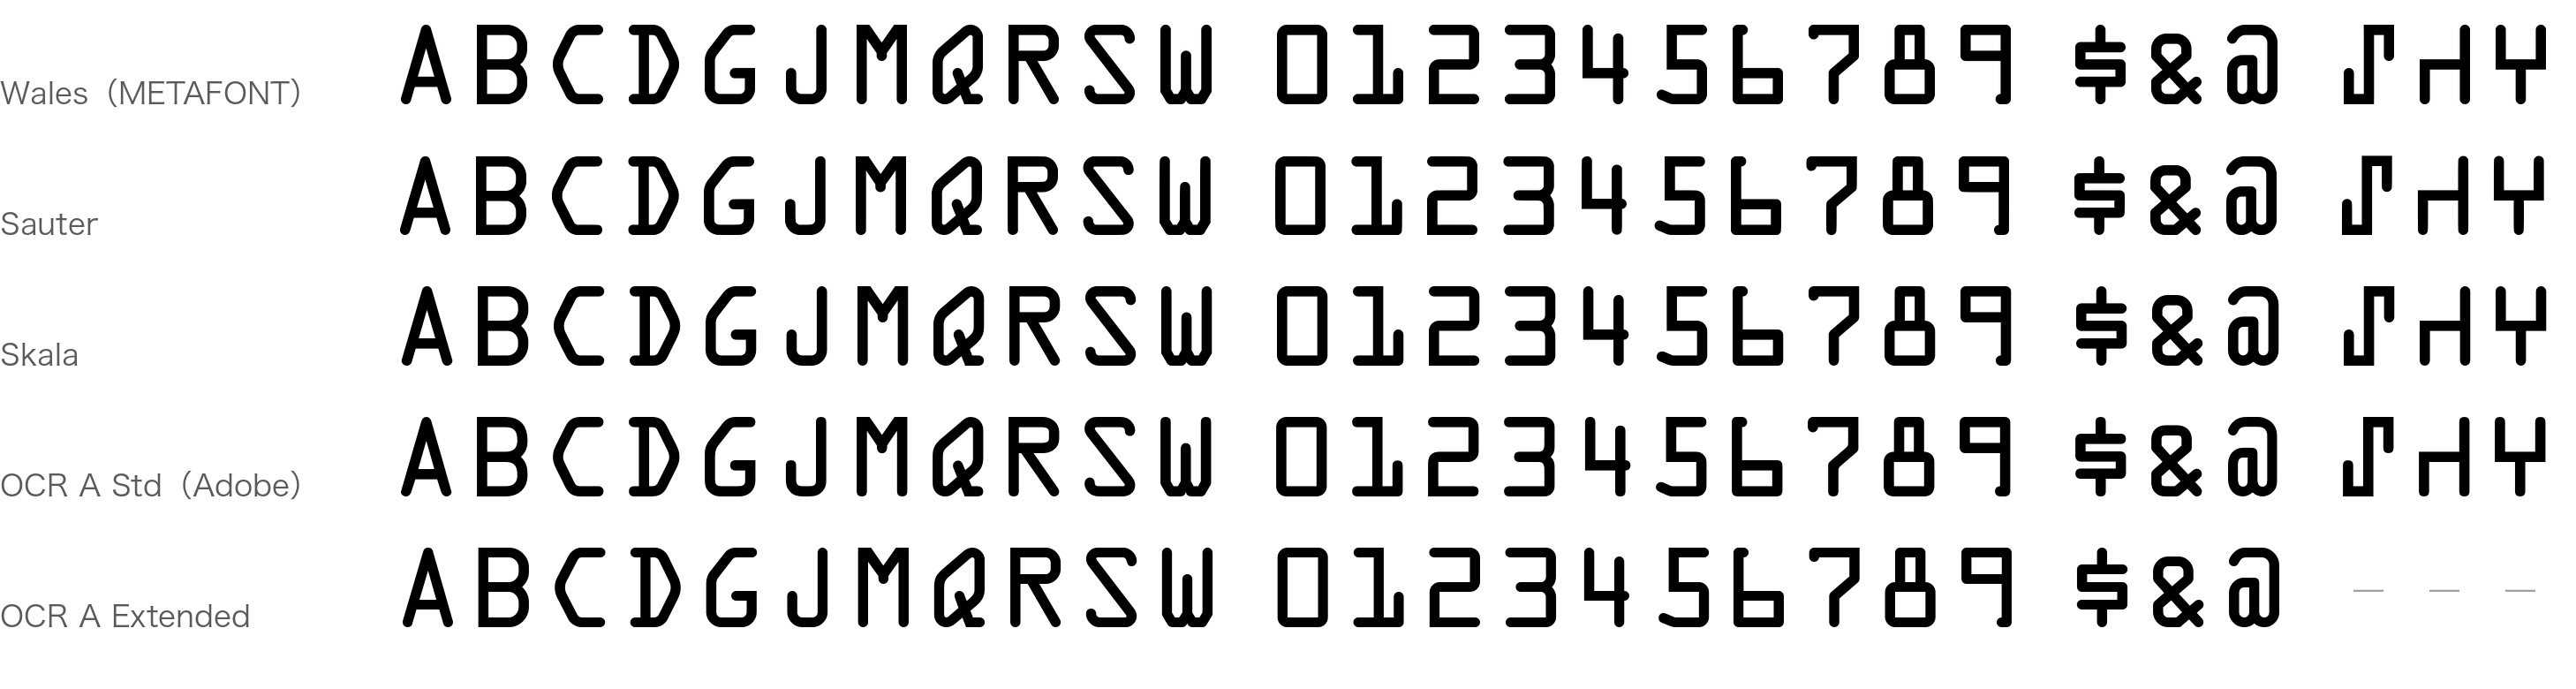
| Wales | Sauter | Skala | OCR A Std | OCR A Extended | |
|---|---|---|---|---|---|
| 形式 | METAFONT(ビットマップに出力して使う) | TrueType・PostScript | TrueType・PostScript・OpenType | OpenType | TrueType |
| 作り方 | ANSI X3.17-1977 から、線を丸いペンで描く定義として書いた | Wales のデータをビットマップにし、輪郭をなぞった | Wales のデータを MetaType1 に移し、輪郭を作った | Adobe のデジタル化(1988年・2002年) | Monotype のデジタル化(1991〜1995年) |
| 字数 | 113字 | 114字 | 115字 | 261字 | 248字 |
| hook・chair・fork | あり | あり(U+2440〜U+2442) | あり(U+2440〜U+2442) | あり(U+2440〜U+2442) | なし |
| 送り(字の高さに対する比) | 0.926 | 0.966 | 0.927 | 0.925 | 0.931 |
| ライセンス | 配布で料金を取らない条件つき | パブリックドメイン | Skala の手を入れた部分はパブリックドメイン(Wales の条件が及ぶ可能性あり) | 市販(Adobe Fonts) | 市販(Microsoft の製品に付属) |
字数と比は、それぞれのフォントのファイルから数えた9294107109110。字の高さは、線の太さを含めた H の高さで測った。Sauter の版は、SourceForge で配られている元のファイル(2004年)を使った(Luc Devroye が2008年に作り直した版ではない)。規格のサイズ I の寸法で計算すると、1インチに10字のときの比は 0.926(0.100インチ ÷ 0.108インチ)で、Wales・Skala・OCR A Std はこれと一致する44。線の太さの比は、OCR A Extended が 0.126、ほかの4つが 0.128〜0.129 で、OCR A Extended がわずかに細い。
細かい違いは次のとおり。
- Sauter の版は、ビットマップの輪郭をなぞって作ったので、大きくすると、G の下の曲がりや 4 の縦の線などの縁がわずかに波打つ。送りも、Wales・Skala より4% ほど広い74110
- Skala の版は、Wales の定義から輪郭を作り直したもので、縁はなめらか。形と送りは Wales の METAFONT とほぼ同じ96107
- OCR A Extended は、hook・chair・fork を持たない代わりに、アクセント付きの字や記号を足して Windows の文字セットに広げている(OCR A Extended を参照)
OCR-A の形をもとにした書体
OCR-A の機械的な形は、のちに書体デザイナーの手で作り直されている。
- Estupido Espezial(1995年): Jonathan Hoefler によれば、1995年に、銀行の取引明細書に使われる OCR-A にはスワッシュ(飾りの付いた字)が要ると思いつき、Adobe Illustrator で10分ほどで見本を描いて Tobias Frere-Jones に送ったところ、1時間もしないうちに「¡¡¡EstupidoEspezial!!!.sit」というファイルが返ってきた。友人の Eric Siry が働いていた『Rolling Stone』誌が使用の許諾を取り、数か月後の「Technology Issue」の特集の頁に使われた111
- OCR A Tribute(2006年): Linotype の書体。Miriam Röttgers が、元のデザインの「non-design design」と、字の種類の少なさを理由に、OCR-A を手直しして広げた。字幅の異なるプロポーショナルの版と等幅の版があり、オールドスタイル数字なども収める。MyFonts で販売している112
- OCR-X(2023年): Maxitype の書体。Eurostandard と Maximage が、1966年の OCR-A の骨格を出発点に、6つの太さに広げた。可変フォントもある21。Maxitype が販売している113。2023年に Maxitype が出した印刷の見本帳『OCR-X Type Specimen』(48ページ、700部)には、Jonas Berthod のエッセイなどと一緒に、OCR-X Regular のデスクトップ用のライセンス(1台分)が付いている114
- OCR-A Axis(2026年): jz5 のフリーのバリアブルフォント。Wales の METAFONT の定義(Skala の OCR パッケージに収められたもの)から字の中心線を取り出して作り直し、線の太さ・角の丸み・傾きを変えられるようにした(OCR-A Axis を参照)
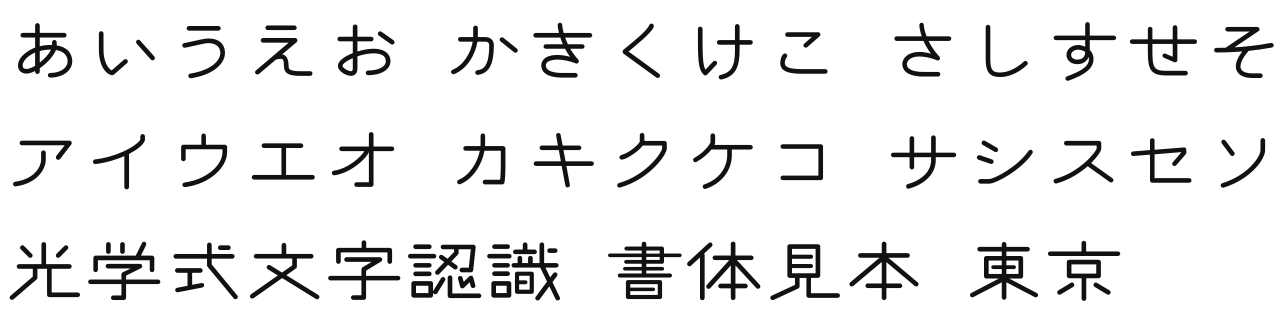
- ヨタG: 視覚デザイン研究所の和文の書体。英語版 Wikipedia の OCR-A の項は、OCR-A をもとにした日本語の書体として挙げている115。視覚デザイン研究所の説明は「スッキリしているのに柔らかな色気や愛嬌がある、穏やかな表情の“癒し系”フォント」で、OCR-A には触れていない116。視覚デザイン研究所が販売していて、Adobe Fonts でも使える117。ただ、欧文と数字の形は OCR-A とよく似ている117
書体とデザインの本での紹介
『改訂 基本レタリング』(1990年)
真覚静子『改訂 基本レタリング』は、「OCR-A フォント〈Optical Character Reader: 光学的文字読とり装置〉」として、大文字と数字の見本を載せている118。
改訂 基本レタリング
著者 - 真覚静子
出版社 - 鳳山社
出版年 - 1990年3月
ISBN - 483160092X
「OCR-A フォント」の見本(p.85)。大文字と数字。
『マッキントッシュフォント・ガイド』(1995年)
Macintosh の欧文フォントの紹介で、OCR-A と OCR-B を挙げている119。
マッキントッシュフォント・ガイド : オリジナルフォントの作成から加工のテクニックまで 本当のタイポグラフィを楽しむ本
著者 - 伊藤, 政行
出版社 - メディア・テック出版
出版年 - 1995年2月
ISBN - 494408014X
欧文書体の一覧(p.118)に OCR-A と OCR-B。
『欧文書体2』(2008年)
小林章は、OCR-B の項で、OCR-A を「アメリカで1966年につくられた」書体として挙げ、OCR-B のデザインは OCR-A に比べて人間の感覚に近いと書いている。バーコードと一緒に使われている数字は、たいてい OCR-B だという15。

欧文書体
2 (定番書体と演出法)
著者 - 小林, 章, 1960-
出版社 - 美術出版社
出版年 - 2008年9月
ISBN - 9784568503647
OCR-B の項(p.110-115)。OCR-A との比較と、アドリアン・フルティガーへのインタビュー。
『タイポグラフィ・ハンドブック』(2012年・2021年)
「OCR/MICR(自動文字認識)」の項で OCR-A を紹介している16。第2版にも同じ趣旨の記述がある120。年代と作り手の記述は、開発の経緯の表を参照。

タイポグラフィ・ハンドブック
著者 - 小泉, 均, 1958-
出版社 - 研究社
出版年 - 2012年7月
ISBN - 9784327377328
「OCR/MICR(自動文字認識)」の項(p.309)。

タイポグラフィ・ハンドブック
著者 - 小泉, 均, 1958-
出版社 - 研究社
出版年 - 2021年7月
ISBN - 9784327377496
第2版(p.380)。
『ABCのみほん』(2013年)
1960年代の後半に、人とコンピューターのどちらでも読める書体が求められるようになったとし、「Computer」「Data 70」「OCR」などは磁気読取や光学読取用にデザインされた文字をもとにしていると書いている121(Moore Computer・Data 70 を参照)。

ABCのみほん
かたちで見分けるフォントガイド
著者 - アイデア編集部 編
出版社 - 誠文堂新光社
出版年 - 2013年1月
ISBN - 9784416113462
磁気読取・光学読取用の文字をもとにした書体として「Computer」「Data 70」「OCR」を挙げる。
『タイポグラフィ・ベイシック』(2018年)
高田雄吉は、「OCR A Standard Regular」の見本を載せ、数字やテキストを正しくスキャンする必要があるときにバーコードなどと併用される、字幅のそろったモノスペースフォントと説明している17。
タイポグラフィ・ベイシック
著者 - 高田, 雄吉, 1953-
出版社 - パイインターナショナル
出版年 - 2018年4月
ISBN - 9784756250841
OCR-A の見本と解説(p.67)。
『SF映画のタイポグラフィとデザイン』(2020年)
著者のデイヴ・アディが、SF 映画で頻度の点で3番目に目にするフォントが OCR-A だと話し、スティーヴン・コールズは、それが未来的に見えるのは「人間ではなくコンピュータが読み取ることを前提にしているからです」と答えている122。本文では、『月に囚われた男』『ブレードランナー』『マトリックス』『第9地区』『パシフィック・リム』『ジュラシック・ワールド』に OCR-A が使われているとしている18。

SF映画のタイポグラフィとデザイン
著者 - デイヴ・アディ 著、篠儀直子 訳
出版社 - フィルムアート社
出版年 - 2020年8月
ISBN - 9784845919024
スティーヴン・コールズへのインタビューで OCR-A を取り上げる。OCR-A が使われた映画(p.227)。
参考資料
電子計算機入力のための文字・図形の自動認識
著者 - 電気学会文字・図形自動認識専門委員会 編
出版社 - 電気学会
出版年 - 1970年
「3.2.1 OCR-A(ISO)」(p.26-27)。9×5 の格子状の文字わく、66字、サイズ I〜IV。3・1図(a) に OCR-A(ISO)の全字。
OCRの導入と活用
著者 - 工藤章次 著
出版社 - 日刊工業新聞社
出版年 - 1972年
ISO の推薦案の OCR-A の字の内訳と「OCR-A 数字サブセット」(p.21)。米国の銀行で OCR-A のタイプライターを使った例(p.108-111)。
文字認識概論
著者 - 橋本新一郎 編著
出版社 - 電気通信協会
出版年 - 1982年3月
表6.1「OCR 用字形関係規格」と、OCR-A・OCR-B・OCR-K の解説(p.174-175)。
流通業のPOS読本
ハイテク時代の情報システム入門
著者 - 浅野恭右 著
出版社 - ビジネス社
出版年 - 1983年11月
米国の小売業の値札に NRMA が OCR-A を選んだ経緯(p.148-149)。
欧米流通情報革命の現場を行く
著者 - 流通システム開発センター 編
出版社 - 日刊工業新聞社
出版年 - 1988年9月
NRMA の OCR-A の値札と、日本が OCR-B を選んだ背景(p.12)。
リンク
OCR A from Adobe Originals
Explore OCR A designed by American Type Founders at Adobe Fonts.
OCR-A font
Download OCR-A font for free. A free OCR-A font, conformant to ANSI X3.17-1977, in TrueType format, with sources.
OCR fonts
OCR font links, compiled by Luc Devroye.
出典・注
-
ISO 1073/I-1976, p.1(「The name of the character set is OCR-A.」「A repertoire of 69 characters」「Character set OCR-A includes the numeric sub-set which was recommended in draft ISO Recommendation No. 890」) ↩ ↩2 ↩3 ↩4 ↩5 ↩6 ↩7
-
玄地宏「文字読取装置の最近の発展」『電子通信学会誌』51巻6号、電子通信学会、1968年6月、772ページ、表2「現在試作ならびに市販されている OCR」 ↩ ↩2
-
関口茂「文字識別装置」『電気学会雑誌』88巻4号、電気学会、1968年4月、616ページ(「ISOのAフォント[第11図(a)参照]や第8図に示すような,Shelf check文字のように単純な線分(ストローク)から構成されている文字を識別する装置に利用される方法」) ↩ ↩2
-
James F. Greenly, Standardization of Typewriter Fonts for Automatic Reading, Rome Air Development Center, 1966年3月(AD 630 471)(「Sectional Committee X3 (Data Processing) formed Subcommittee X3.1 (Optical Character Recognition) in 1961」「Known as the TG1C font to that organization」「Distinct differences were provided between “B” and “8”, “I” and “1”, “5” and “S”, and “Oh” and zero」。2026年10月20日閲覧) ↩ ↩2 ↩3 ↩4 ↩5 ↩6 ↩7 ↩8 ↩9
-
ANSI X3.17-1981, 表紙・Abstract・委員会の頁(「Approved June 16, 1981」「OCR-A was designed to provide maximum machine efficiency under a wide range of applications.」「Subcommittee X3A1 on Optical Character Recognition, which developed this standard」「Special appreciation is extended to the National Bureau of Standards Instrument Shops for correcting the masters to reflect a correct centerline drafting notation.」) ↩ ↩2 ↩3 ↩4 ↩5
-
ANSI X3.17-1981 Character Set for Optical Character Recognition (OCR-A), American National Standards Institute, Foreword(「The OCR-A character set for optical character recognition was first developed in the United States in 1961 as a numeric font only. In 1966 an alphanumeric font which contained 57 characters, including the existing numeric font, 4 abstract characters, and only capital letters, was issued.」。FIPS PUB 32-1 に添付されたもの) ↩ ↩2 ↩3 ↩4 ↩5 ↩6 ↩7 ↩8 ↩9 ↩10
-
橋本新一郎編著『文字認識概論』電気通信協会、1982年、174〜175ページ(「OCR-A フォント 米国案を基に規格化した字形で,数字,英大文字,記号(JIS では合計62字)がある。」。国立国会図書館デジタルコレクション。「ストロークアナリシスを意識した線素構成をとっているので,人間の眼にはやや不自然さが残っているが,OCR では単純な回路でも高い読取精度が期待できる。」) ↩ ↩2 ↩3 ↩4 ↩5
-
ECMA-8 Nominal Character Dimensions of the OCR-A Font, 1st Edition, European Computer Manufacturers Association, 1965年4月, Brief History・寸法の表(「ECMA TC 4 started its standardization work in the field of Optical Character Recognition in June 1961.」「Adopted on April 30, 1965 by the General Assembly of ECMA as Standard ECMA-8.」) ↩ ↩2 ↩3 ↩4 ↩5 ↩6
-
ISO 1073/I-1976 Alphanumeric character sets for optical recognition — Part I: Character set OCR-A — Shapes and dimensions of the printed image, First edition 1976-12-01, Foreword(「was circulated to the Member Bodies in May 1975.」「This International Standard, together with ISO 1073/II, cancels and replaces ISO Recommendation R 1073-1969.」) ↩ ↩2
-
ANSI X3.17-1981, p.10(「The nominal printed image of each character is specified by its stroke centerlines and by its nominal stroke width.」「to establish both a machine-readable and human-readable standard character set, designed for optimizing OCR readability.」「it is not required that the printed corner radii be less than 0.004 in (0.10 mm).」) ↩ ↩2 ↩3 ↩4 ↩5 ↩6
-
National Bureau of Standards, FIPS PUB 32 Optical Character Recognition Character Sets, 1974年12月1日, Abstract・p.1(「Style A comprises a font of 92 characters which is designed to provide a maximum of machine efficiency in reading under a wide variety of applications. Style B comprises a font of 96 characters, which stresses esthetic appearance」) ↩ ↩2 ↩3
-
National Bureau of Standards, FIPS PUB 32-1 Character Sets for Optical Character Recognition (OCR), 1982年6月25日, p.2(「This revised version became effective on June 25, 1982.」) ↩
-
NIST「Withdrawn FIPS Listed by Number」(「32-1 Character Sets for Optical Character Recognition (OCR) … 82 Jun 25 96 May 29」。2026年10月20日閲覧) ↩
-
関口茂「文字識別装置」『電気学会雑誌』88巻4号、電気学会、1968年4月、617ページ(「わが国の分科会(ISO-SC3規格委員会)もその討議に参加している。」「AフォントはアメリカASAから提案されたもので,線分により構成された文字でやや不自然であるが,BフォントはヨーロッパECMAから提案されたものでかなり自然の形に近い。」) ↩ ↩2 ↩3
-
小林章『欧文書体2 定番書体と演出法』美術出版社、2008年、111ページ(「アメリカで1966年につくられたOCR-A(オーシーアール・エー)」「それに比べると OCR-B のデザインは人間の感覚に近い感じがします。」) ↩ ↩2 ↩3
-
小泉均編著『タイポグラフィ・ハンドブック』研究社、2012年、309ページ「OCR/MICR(自動文字認識)」(「規格フォントは1968年に開発され, OCR-A は ANSIX3.4-1977 に基づき ATF から発表された」) ↩ ↩2
-
高田雄吉『タイポグラフィ・ベイシック』パイ インターナショナル、2018年、67ページ(「USA Bureau of Standardsの開発による。」「書籍コードに使用されているのは視覚的に読みやすいOCR B(1968年アドリアン・フルティガー制作)。」) ↩ ↩2
-
デイヴ・アディ『SF映画のタイポグラフィとデザイン』篠儀直子訳、フィルムアート社、2020年、227ページ(「光学文字認識システムのために1968年にデザインされたOCR-Aだ。」) ↩ ↩2
-
Adobe Fonts「OCR A」(「In 1968, American Type Founders produced OCR-A, one of the first optical character recognition typefaces to meet the criteria set by the U.S. Bureau of Standards.」「OCR-A follows the 1981 standard set by the American National Standards Institute (ANSI), X-3.17-1981 (size I). The same design is also specified for the German DIN 66008 standard.」。2026年10月20日閲覧) ↩ ↩2
-
Monotype「OCR A Extended」(「OCR A was developed to meet the standards set by the American National Standards Institute in 1966」「because of its “techno” look, it has been re-discovered for advertising and display graphics.」。2026年10月20日閲覧) ↩ ↩2
-
Maxitype「OCR-X」見本帳、2023年(「OCR-X is both a homage to and an extension of the infamous OCR-A typeface from 1966.」「OCR-A was created in 1966 (1) by the American Type Founders (ATF) on a commission by the American National Standards Institute」。2026年10月20日閲覧) ↩ ↩2
-
ECMA-8 Nominal Character Dimensions of the Numeric OCR-A Font, 2nd Edition, 1977年1月, 前書き・p.1-3(「The OCR-A character set comprises 14 characters」「The present 2nd Edition of Standard ECMA-8 differs from the 1st Edition only in editorial matters.」) ↩ ↩2 ↩3
-
ECMA-19 Code for the Representation of MICR and OCR Characters, 1969年6月, p.6(「2.2 Standard ECMA-8-OCR-A 10 numerals 3 special symbols」) ↩
-
ECMA-19, 1969年6月, p.10, 付録(「In the ISO Recommendation 1073 an alphabet of 26 upper case letters and 18 symbols having the same stylization are added to the OCR-A numeric set.」) ↩
-
工藤章次『OCRの導入と活用』日刊工業新聞社、1972年、21ページ(「OCR-A はもともとアメリカで開発されたもので,英字 26,数字 10,記号 3,垂線マーク 1,貨幣記号 3(¥記号も含まれている),特殊記号 16,特殊文字 7 からなり」。国立国会図書館デジタルコレクション) ↩
-
K. I. Larsson「Notes on transfer of responsibility for OCR-B standards」ISO/IEC JTC 1/SC 2/WG 3 N 504、2000年9月15日(「The only internationally formally standardized fonts are those developed for OCR purposes in the sixties, in th US and in Europe.」「After the ISO 1073 was published in 1976, no changes to it were requested until 1993.」。2026年10月20日閲覧) ↩
-
DIN Media「ISO 1073-1」(「Status: Current」。2026年10月20日閲覧) ↩
-
安岡孝一「Prehistory of JIS X standards」(「JIS C 6250-1970 光学式文字認識のための字形(英数字) (1970年6月1日制定)」「JIS X 9001-1976 … (1987年3月1日被移行)」。2026年10月20日閲覧) ↩
-
日本規格協会「JIS X 9001:1976 光学式文字認識のための字形(英数字)」(制定 1970-06-01、改正 1976-11-01、確認 2024-06-20。2026年10月20日閲覧) ↩
-
「JIS X 9001:1976 光学式文字認識のための字形(英数字)」kikakurui.com(「字体は2種類とし,それぞれOCR-A,OCR-Bと呼ぶ。」。2026年10月20日閲覧) ↩ ↩2
-
橋本新一郎編著『文字認識概論』電気通信協会、1982年、174ページ、表6.1(国立国会図書館デジタルコレクション) ↩
-
JIS X 9004:1983「光学式文字認識のための印字仕様」の表(「JIS C 6250 で規定するすべての文字」) ↩
-
ISO 1073/I-1976, p.2(「It is recommended that the letter Y and the abstract symbol fork should not both be used in the same application.」) ↩ ↩2 ↩3
-
ANSI X3.17-1981, p.13, Table 1 ↩
-
ISO 1073/I-1976, p.3(「All edges should be blended, with rounded corners.」) ↩
-
電気学会文字・図形自動認識専門委員会編『電子計算機入力のための文字・図形の自動認識』電気学会、1970年、26〜27ページ(「OCR 用フォントとして ISO から提案されているもので,9×5 の格子状文字わくに表現された文字である.」。国立国会図書館デジタルコレクション) ↩
-
坂井利之「文字読取装置と音声用装置」『情報処理』6巻6号、情報処理学会、1965年11月、353ページ(第4図「文字読取り用標準文字: OCR-A」「右端には E13B と同様必ず縦の線が上か下かのいずれかにあって,この信号はインクのしみやよごれなどでは生じないほど安定なものであり,タイミングの基準となる.」) ↩ ↩2
-
ANSI X3.17-1981, p.11(2.4 特殊記号。「Four special characters are provided and recommended for use where control symbols are required.」「it is common practice to preprint an entire form with such format lines」)。字形の図の一覧(Fig. 11 Hook、Fig. 12 Fork、Fig. 13 Chair、Fig. 14 Long Vertical Mark) ↩ ↩2 ↩3 ↩4 ↩5 ↩6 ↩7 ↩8 ↩9
-
Die Deutsche Kreditwirtschaft「Richtlinien für einheitliche Zahlungsverkehrsvordrucke (2016)」1.5、3.2.3.4(「Die drittletzte Zeile aller Scheckvordrucke (Codierzeile) darf nur mit OCR-A1-Zeichen gemäß DIN 66 008-1 „Schrift A für die maschinelle optische Zeichenerkennung, Zeichen und Nennmaße“ versehen werden.」。2026年10月20日閲覧) ↩ ↩2
-
ANSI X3.17-1981, Appendix E(「Note that the three symbols Hook, Fork, and Chair can be used as control symbols or to represent the characters Tilde, Underline, and Grave Accent, respectively.」) ↩
-
FIPS PUB 32, 1974, p.7(「The alternate graphic shapes avoid the use of small printing areas which may permit physical penetration of the form substrate.」) ↩
-
FIPS PUB 32, 1974, p.9(「It can be recognized distinctly with respect to other characters in this Part II solely by its unique (total) printing area.」) ↩
-
ANSI X3.17-1981, p.48, Appendix C(「Size I was developed for devices such as high-speed line printers and typewriters.」「Size II was developed in Europe and is not used in the United States, nor is it included in this standard.」「Size IV was developed because of the problems encountered in printing from embossed plastic cards and metal plates.」) ↩ ↩2
-
ECMA-18, 1st Edition, 1968年11月(「Size IV characters have been designed primarily for credit card imprinting」) ↩
-
ECMA-18, 2nd Edition, 1977年1月, 前書き(「The main differences between the two editions relate to the replacement of Size II by Size IV」) ↩
-
FIPS PUB 32, 1974, p.10(「A margin shall be at least 0.250 in (6.35 mm).」) ↩
-
FIPS PUB 32, 1974, p.11(「Character skew shall not exceed 3 degrees.」) ↩
-
ANSI X3.86-1980 Optical Character Recognition (OCR) Inks, Foreword・p.7(「read inks should have a reflectance throughout the spectral region of interest of less than 18%」「Read inks shall not have a reflectance greater than 40%.」) ↩
-
ECMA-15 Print Specifications for Optical Character Recognition, 2nd Edition, 1975年8月, p.9・p.16(「Range X-high quality, Range Y-medium quality.」)。JIS X 9004:1983 の表も同じ値 ↩
-
Issei Yamasaki, “A Method for Quantitative Print Quality Evaluation of a Large Number of Data”『電子技術総合研究所研究報告』731号、電子技術総合研究所、1972年、Synopsis(「numerals of OCR-A font printed with a line printer」。国立国会図書館デジタルコレクション) ↩
-
池田敏雄編『電子計算機概論 計算機システムと情報処理』第2版、オーム社、1974年、166ページ(「OCR-A 活字は,この手法に有効なように設計されており,各文字を構成するストロークを注意すると,それらストロークによって文字はコード表現されることがわかる」。国立国会図書館デジタルコレクション) ↩
-
玄地宏「文字読取装置の最近の発展」『電子通信学会誌』51巻6号、電子通信学会、1968年6月、776ページ(「これは字体自身がそのような線素から構成されているからで」) ↩
-
玄地宏「文字読取装置の最近の発展」『電子通信学会誌』51巻6号、電子通信学会、1968年6月、773〜774ページ(「ISO-Aフォントも国際的に統一しようという運動で」) ↩
-
玄地宏「文字読取装置の最近の発展」『電子通信学会誌』51巻6号、電子通信学会、1968年6月、774ページ(「あるフォントは読みやすさの点で問題があり」「各文字は機械認識に適するように作られた一種の符号であるから,読取装置が簡単になることと,符号で構成されているために誤読を少なくすることができる点が有利である」) ↩ ↩2
-
坂井利之「文字読取装置と音声用装置」『情報処理』6巻6号、情報処理学会、1965年11月、356ページ(「CZ 13 は OCR-A と同系統のものと考えてよく」) ↩
-
「周辺装置性能一覧表」『情報科学』5巻5号、情報科学研究所、1969年5月、25ページ(国立国会図書館デジタルコレクション) ↩
-
日立製作所「日立光学文字読取装置 OCR」(広告)『事務と経営』27巻325号、日本経営協会総合研究所、1975年4月(「活字ならアルファベットも全部読みます(OCR-A活字、OCR-B活字)」。国立国会図書館デジタルコレクション) ↩
-
ANSI X3.49-1975 (R1982) Character Set for Optical Character Recognition (OCR-B), Foreword(「For the numeric and uppercase character sets of OCR-A the emphasis is on OCR reading performance, while for OCR-B the emphasis is on conventional appearance.」「The objective is to provide a choice for the user — optimized reading performance or conventional appearance.」) ↩
-
『流通とシステム』12号、流通システム開発センター、1977年6月、15〜16ページ、表3〜7(「アメリカでは OCR-A フォントで統一しようとしているが,日本は OCR-B の市場が多く,統一伝票に採用しているなど,人間識別が容易なBフォントの使用率が高い」。国立国会図書館デジタルコレクション。「OCR-A フォントは,従来の光学文字読取り技術からの要請に基づいて,機械に読みやすいように変形をほどこした字体である.これに対して,OCR-B フォントは,原理的な読みやすさを確保するとともに,美的にも満足すべき字形であって,広く一般事務用にも使えることを目標とした字体である.」) ↩ ↩2
-
小林章『欧文書体2 定番書体と演出法』美術出版社、2008年、112ページ(アドリアン・フルティガーへのインタビュー。「問題を分析するところから始めたんだ。だから制作には全部で5年間かかったよ。」) ↩
-
流通システム開発センター編『欧米流通情報革命の現場を行く』日刊工業新聞社、1988年、12ページ(「OCR−Bフォントはコスト・技術面でもOCR−Aフォントに明らかに劣っていたのである」。国立国会図書館デジタルコレクション) ↩ ↩2
-
浅野恭右『流通業のPOS読本』ビジネス社、1983年、148〜149ページ(「NRMAでは、各メーカーから提出された仕様から、一九七三年一一月、OCR−Aフォントを選んだ。」「その当時は、OCR−Aフォントだけがアメリカの標準化局の認定方式であったが」。国立国会図書館デジタルコレクション) ↩ ↩2
-
『流通とシステム』5号、流通システム開発センター、1975年10月、35ページ(国立国会図書館デジタルコレクション。「UVM は表示文字として,OCR−A フォント(サイズ I—規格 ANSI×3A/73−110)を決定した」) ↩ ↩2
-
『季刊輸送展望』162号、日通総合研究所、1977年4月、48〜49ページ(「全米小売商協会(NRMA)中心に標準化活動が組織化され、1974年春OCRAフォント値札の採用がきまった」。国立国会図書館デジタルコレクション) ↩ ↩2
-
『事務と経営』30巻365号、日本経営協会、1978年1月、57ページ(「1974年NRMAで正式採用が決ったOCRAフォント値札の採用に本格的に踏切っているのは現在のところシアーズとJ.C.ペニーだけ」。国立国会図書館デジタルコレクション) ↩
-
『日本百貨店協会会報』986号、日本百貨店協会、1977年10月、14〜15ページ(写真3・4。「値札と同じ OCR−A フォントで口座 No. がプリント」。国立国会図書館デジタルコレクション) ↩
-
ISO/IEC 7811-1:2018 Identification cards — Recording technique — Part 1: Embossing(プレビュー。「ISO 1073-1, OCR-A, Sizes I and IV; — ISO 1073-2, OCR-B, Sizes I and IV; — Type font Farrington 7B」。2026年10月20日閲覧) ↩
-
玄地宏「文字読取装置の最近の発展」『電子通信学会誌』51巻6号、電子通信学会、1968年6月、770ページ(「現在までに実用されている OCR システムの大部分はこの形をとっている.」) ↩
-
工藤章次『OCRの導入と活用』日刊工業新聞社、1972年、108〜111ページ(「タイプライタには ANSCSOCR-A(以前は,USASCSOCR-A と呼ばれていたが,USASI が機構改革によって ANSI と改名されたため,従来のそれぞれの規格の前に ANS を付して,ANSXXXX という形で呼称するようあらためられた)フォントが取り付けられた.」。国立国会図書館デジタルコレクション、110〜111ページ) ↩
-
National Bank of Canada「Automated Lockbox Specifications」(「The standard OCR-A font (ANSI X3.17-1981) is required.」。2026年10月20日閲覧) ↩
-
John Sauter「ReadMe.txt」(「A site license for the OCR-A font is very expensive, so I undertook to create a free font.」「I found an exact match」「FontForge is able to write both PostScript and TrueType font files, so I wrote both.」。2026年10月20日閲覧) ↩ ↩2 ↩3 ↩4 ↩5 ↩6
-
Matthew Skala「OCR A and OCR B」Tsukurimashou Project(「my own contributions are public domain, and others have licensed their copyright claims.」「OCR-A is the font used for the ISBNs on books; and OCR-B is used for the human-readable digits on UPC/EAN bar codes.」。2026年10月20日閲覧) ↩ ↩2 ↩3
-
Book Industry Study Group「Barcoding Guidelines for the US Book Industry」(「The font for the human readable ISBN should be a sans serif font such as OCR-B or ARIAL.」。2026年10月20日閲覧) ↩
-
日本図書コード管理センター「ISBN(国際標準図書番号)および日本図書コード・書籍JANコード 利用の手引き 2025年版」22・33ページ(「かつては「日本図書コード」をOCR-B(読み取り端末に対応した文字)で表現し、レジ等に読み込ませていました。」「OCR −B フォントは不可。それ以外のきちんと視認できるフォントで表記する(処理機器に不具合を起こす危険があるため)。」「バーコード下の添え数字は目視可能文字とし、OCR-BフォントでJISに準拠し作成のこと。」。2026年10月20日閲覧) ↩
-
ECMA-19, 1969年6月, p.7, 表III ↩
-
ISO 2033-1983 Information processing — Coding of machine readable characters (MICR and OCR), p.8, Table 7(「In general, this symbol is not used in conjunction with the alphabetic characters because of its potential interference with the letter Y.」) ↩ ↩2
-
JIS X 9010:1984「機械読取り可能文字の符号(OCR及びMICR)」の OCR-A 図形文字集合 ↩
-
ISO-IR 91「Japanese OCR-A Graphic Character Set」1985年8月1日登録(「A set of 59 graphic characters of the OCR-A font. This code table is derived from Table 3 of ISO 2033 - 1983 … by adding the YEN SIGN in position 5/12.」「Origin: Japanese Industrial Standard JIS C 6229-1984」。2026年10月20日閲覧) ↩
-
FIPS PUB 32, 1974, p.8 ↩
-
Unicode Character Database「UnicodeData.txt」「NamesList.txt」「DerivedAge.txt」(「@ OCR-A」「@ MICR」「2440..244A ; 1.1」。2026年10月20日閲覧) ↩ ↩2
-
IBM「Specials, OCR/MICR symbols」(GCGID の表。Internet Archive の2012年6月23日の保存版。2026年10月20日閲覧) ↩
-
IBM『Selectric Typewriter Type Styles』1970年(「USASI OCR Code 056 10 Pitch」「Communications OCR Code 091 10 Pitch」。2026年10月20日閲覧) ↩
-
IBM『3203 Printer Model 5 Component Description』GA33-1529-0、1979年1月、Figure 8「Train Arrangements」(「“OAA” (48 “OCR A” FONT GRAPHICS) 5 IDENTICAL ARRAYS」。2026年10月20日閲覧) ↩
-
MyFonts「OCR A」(Linotype。「The OCR A Font Family was designed by USA Bureau of Standards and published by Linotype.」。2026年10月20日閲覧) ↩
-
MyFonts「OCR-A M」(URW。「Designers: British Standards Institute」。2026年10月20日閲覧) ↩
-
Luc Devroye「OCR fonts」(「MyFonts pencils OCR-A down under the name of BSI, but I think that font was made by URW++.」。2026年10月20日閲覧) ↩
-
Microsoft「OCR A Extended font family」(「Optical Character Recognition face extended to the regular Win Ansi character set.」「File name Ocraext.ttf」「License Microsoft fonts for enterprises, web developers, for hardware & software redistribution or server installations」(リンク先は Monotype の fonts.com)。2026年10月20日閲覧) ↩ ↩2 ↩3 ↩4 ↩5 ↩6
-
フォントファイル「OCR A Std」(Adobe、Adobe Fonts)の name テーブル・cmap・hmtx ↩ ↩2 ↩3 ↩4 ↩5
-
Microsoft「Microsoft typography font list (Office)」(2026年10月20日閲覧) ↩
-
フォントファイル「OCR A Extended」(OCRAEXT.TTF、Monotype)の name テーブル・cmap ↩ ↩2 ↩3 ↩4 ↩5
-
Richard B. Wales の METAFONT のソースの冒頭の著作権表示(Matthew Skala の msk-ocra.mp に転記されたもの。「Source of information: ANSI Standard X3.17-1977 (approved January 20, 1977, by the American National Standards Institute, Inc.)」「Based on an earlier version by: Tor Lillqvist Computing Services Technical Research Centre of Finland」「do not charge any fee for distribution of either the source or any fonts derived from it beyond a reasonable copying or communications charge.」「I supplemented the standard with my own designs for these four characters.」) ↩ ↩2 ↩3 ↩4
-
Matthew Skala, OCR A and OCR B, version 0.4pre, 2021年7月1日(「I released an earlier version in 2006 but that is now obsolete; the present version is newly derived in 2011 from the Wales version.」。2026年10月20日閲覧) ↩ ↩2 ↩3 ↩4 ↩5 ↩6
-
Nelson H. F. Beebe, 25 Years of TeX and METAFONT: Looking Back and Looking Forward(TUG 2003 の講演の原稿、PDF。年表に「1977–1978 classic TEX and METAFONT in SAIL (D. Knuth)」「1983–1985 ‘final’ TEX and METAFONT in Pascal」。2026年10月20日閲覧) ↩
-
Tor Lillqvist の METAFONT のソース ocr-a.mf の冒頭(CTAN の fonts/ocr-a。「Coded in METAFONT84 by Tor Lillqvist, VTT/ATK (Technical Research Centre of Finland, Computing Services)」「Based on ISO Recommendation R1073, 1st ed., May 1969」) ↩ ↩2
-
CTAN「metafont」(「The program takes a programmatic specification of a font, and produces a bitmap font (whose properties are defined by a set of parameters of the target device), and metrics for use by TeX.」。2026年10月20日閲覧) ↩
-
The Document Foundation「Developer Interview: Tor Lillqvist」2011年(「Since the late 1990s until last year or so, I ported GTK+ to Windows, initially to get GIMP, and then took part in maintaining the port.」。2026年10月20日閲覧) ↩
-
CTAN「ocr-a」(「derived from ANSI Standard X3.17-1977」「Licenses Do Not Sell Except by Arrangement」「Copyright 1988, 1989 Richard B. Wales」。2026年10月20日閲覧) ↩ ↩2
-
SourceForge「OCR-A font」(「A free OCR-A font, conformant to ANSI X3.17-1977, in TrueType format, with sources.」「License: Public Domain」「Registered 2004-10-10」。2026年10月20日閲覧) ↩ ↩2
-
Debian「fonts-ocr-a の copyright」(「License: public-domain」。2026年10月20日閲覧) ↩
-
Luc Devroye「John Sauter」(「I found some problems in the truetype file, so I used FontForge to generate [OCRA] in 2008 in Truetype, Opentype and type 1 formats, leaving the Sauter copyright intact inside the font.」。2026年10月20日閲覧) ↩
-
フォントファイル「OCRA.ttf」(Luc Devroye が2008年に作り直したもの。luc.devroye.org の OCRA.zip)と、SourceForge の元のファイルの hhea・グリフ名・輪郭の比較 ↩
-
Matthew Skala「Tsukurimashou: A Japanese-language font meta-family」『TUGboat』34巻3号、2013年、269ページ(PDF。所属は Department of Computer Science, University of Manitoba。2026年10月20日閲覧) ↩
-
フォントのファイル OCRA.otf・OCRA.ttf(OCR A 0.3.1、Version 2)の name テーブル・cmap・GSUB ↩ ↩2 ↩3 ↩4
-
Matthew Skala の OCR A 0.3.1 のソース msk-ocra.mp の冒頭(「I, Matthew Skala, release my work on this to the public domain. However, the copyright notice below, from the METAFONT code I used as a source, may be applicable.」) ↩ ↩2
-
Richard B. Wales の METAFONT のデータ(ocr.mf、CTAN)と、それを METAFONT で出力したビットマップ ocr10.pk(John Sauter が SourceForge で配布、2004年9月22日の出力) ↩
-
フォントファイル「OCRA.ttf」(John Sauter、SourceForge、Version 001.000)の cmap・hmtx ↩ ↩2
-
Jonathan Hoefler「Two Fools」Hoefler & Frere-Jones(Internet Archive の2008年9月6日の保存版。「that the OCR-A font — used on bank statements and designed for optical character recognition — really needed to be outfitted with a set of swashes.」。2026年10月20日閲覧) ↩
-
MyFonts「OCR A Tribute」(Linotype。「In 2006, Miriam Röttgers revised and extended OCR-A, creating OCR A Tribute.」。2026年10月20日閲覧) ↩
-
Draw Down「OCR-X Type Specimen / Maxitype」(「Includes an essay by Jonas Berthod, The (X)erox Tales ASCII comic, and a desktop license (1 CPU) for OCR-X Regular.」。2026年10月20日閲覧) ↩
-
真覚静子『改訂 基本レタリング』鳳山社、1990年、85ページ ↩
-
伊藤政行著、デジタル・クリエイターズ連絡協議会監修『マッキントッシュフォント・ガイド』メディア・テック出版、1995年、118ページ ↩
-
小泉均・akira1975『タイポグラフィ・ハンドブック 第2版』研究社、2021年、380ページ ↩
-
アイデア編集部編『ABCのみほん かたちで見分けるフォントガイド』誠文堂新光社、2013年(「「Computer」「Data 70」「OCR」などは、磁気読取や光学読取用にデザインされた文字をもとにしています。」) ↩
-
デイヴ・アディ『SF映画のタイポグラフィとデザイン』篠儀直子訳、フィルムアート社、2020年(スティーヴン・コールズへのインタビュー。「わたしが頻度の点で3番目に目にするフォントはOCR-A、国際標準化機構が標準と定めた光学文字認識フォントなんです。」) ↩